
Cómo Uber usa Kafka como cola sin que un mensaje trabe todo
Uber mueve trillones de mensajes al día por Kafka. Así resolvió el head-of-line blocking, el aislamiento y el costo de hardware al usarlo como cola de tareas, con los diagramas originales de sus ingenieros.
Este estudio sigue, paso a paso, dos artículos del blog de ingeniería de Uber: "Enabling Seamless Kafka Async Queuing with Consumer Proxy" (Qichao Chu, George Teo, Haitao Zhang y equipo, agosto de 2021) e "Introducing uFowarder: The Consumer Proxy for Kafka Async Queuing" (Zhifeng Chen, Yang Yang y Haifeng Chen, febrero de 2026). Los diagramas son los originales de Uber, con su crédito en cada uno.
Uber tiene una de las mayores instalaciones de Apache Kafka del mundo: trillones de mensajes y varios petabytes al día. En 2021, más de 300 microservicios ya lo usaban como cola de mensajes entre servicios, y esa cola había pasado de 1 a 12 millones de mensajes por segundo en cinco años. El problema que resolvieron aparece en cualquier sistema que use Kafka como cola de tareas.
1. El problema: Kafka ordena, una cola no lo necesita
Kafka es un sistema de streaming y garantiza el orden dentro de cada partición. Para eso, una partición la lee un solo consumidor del grupo, y el patrón recomendado es leer un mensaje, procesarlo, confirmarlo y recién pasar al siguiente. En una cola de tareas el orden no importa, porque cualquier consumidor puede tomar cualquier mensaje. Cuando se usa Kafka como cola, ese orden se paga de dos maneras.
La primera es la cantidad de particiones. Uber lo explica con un ejemplo que presenta como hipotético: un servicio de cobro lee eventos de "viaje completado" y le cobra a Visa o a Mastercard. Si cada cobro tarda 1 segundo, procesar 1,000 eventos por segundo exige 1,000 particiones. Un cluster sostiene cerca de 200,000, así que con ese diseño caben unos 200 topics, y cada partición, capaz de mover unos 10,000 mensajes por segundo, trabaja a 1.
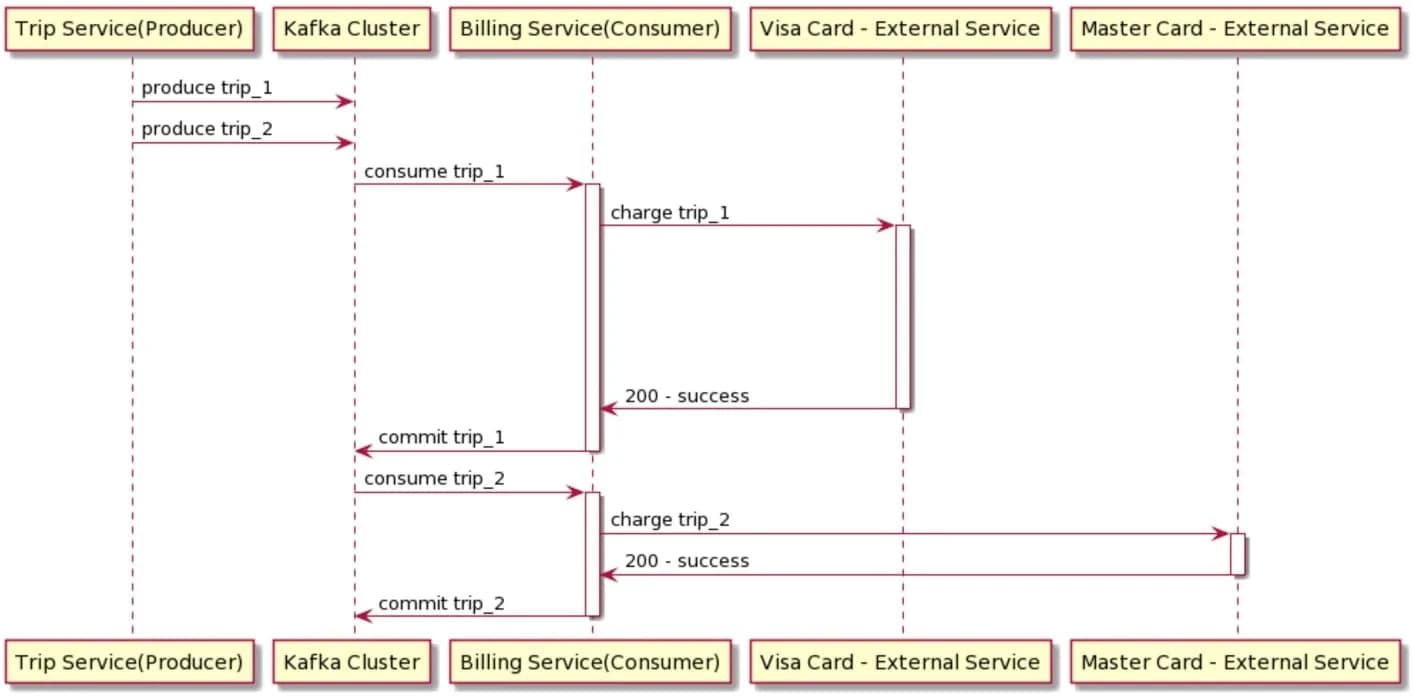
La segunda es el bloqueo de cabeza de fila (head-of-line blocking). Si Visa responde lento, el cobro de trip_2 con Mastercard espera detrás de trip_1, aunque Mastercard esté bien. Y si trip_1 es un mensaje veneno (poison pill), uno que falla siempre, la partición completa se detiene.
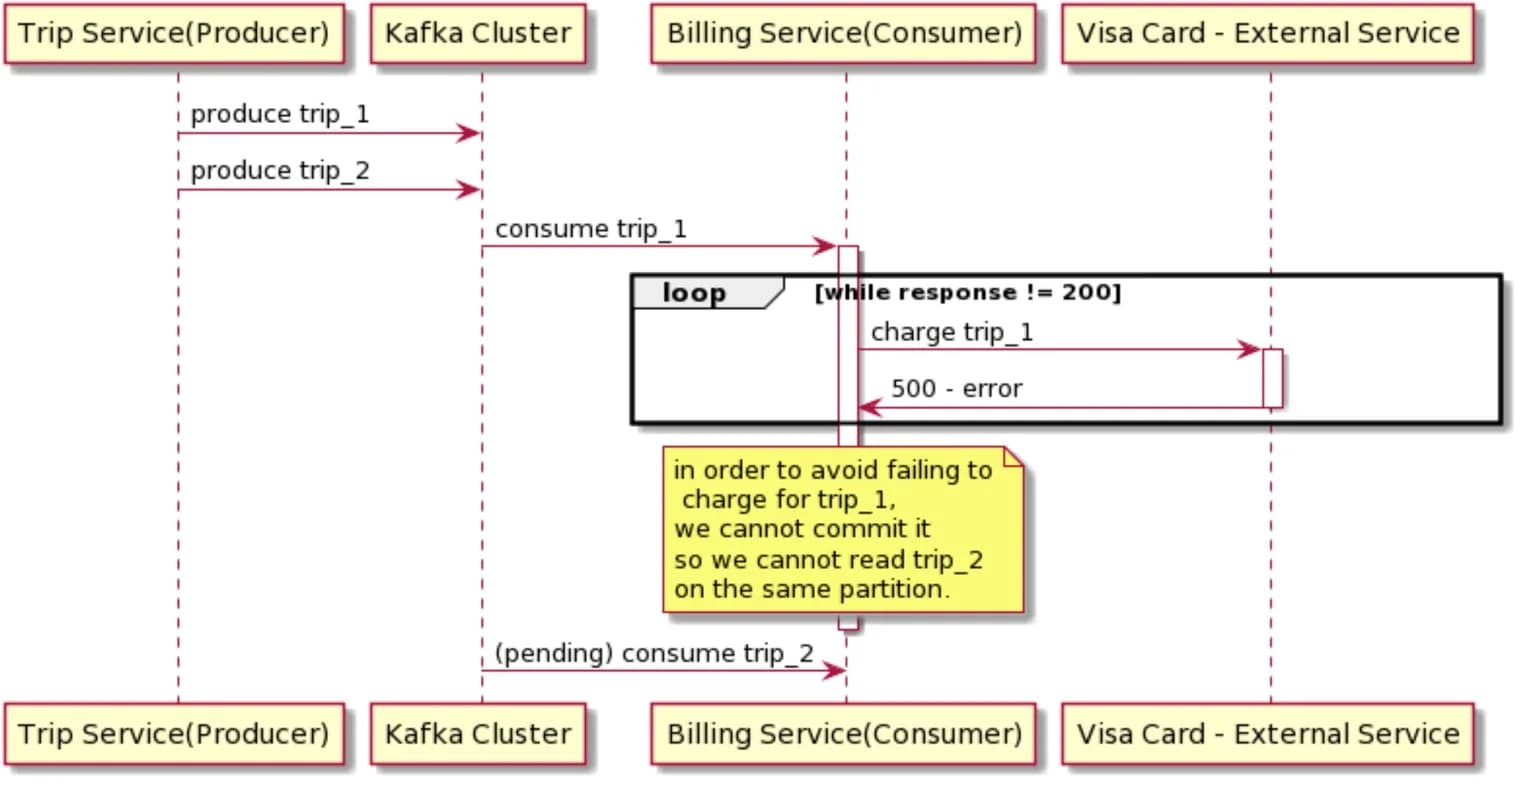
El consumidor estándar de Kafka ofrece dos salidas y ninguna resuelve esto. El autocommit confirma antes de procesar, y si el consumidor se reinicia, lo que estaba en memoria se pierde, algo inaceptable en un cobro. Bajar la latencia tampoco alcanza: con 100 ms por llamada, una partición procesa apenas 10 mensajes por segundo.
2. La idea: un proxy entre Kafka y los servicios
Uber primero intentó una librería sobre los clientes de Kafka para Go y Java, y la descartó por cuatro razones: mantenerla en Go, Java, Python y NodeJS; actualizarla en más de 1,000 microservicios, algo que toma meses; las tormentas de rebalanceo en los reinicios escalonados; y que un topic de 4 particiones solo reparte trabajo a 4 instancias.
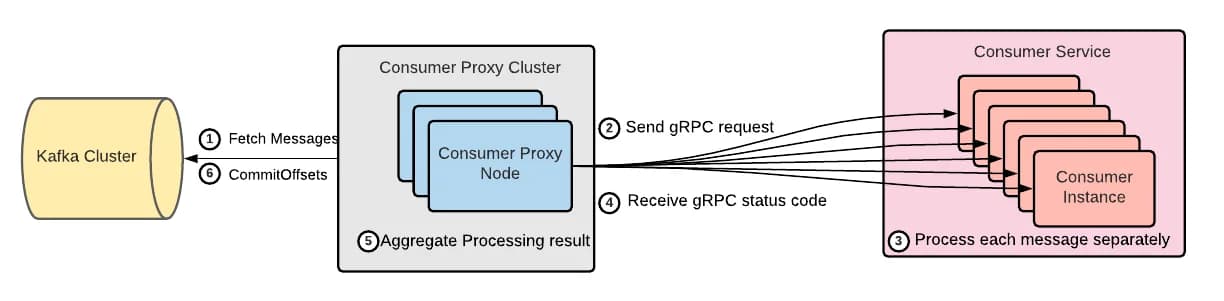
La alternativa fue Consumer Proxy, hoy open source como uForwarder. El proxy lee de Kafka, envía cada mensaje por separado a una instancia del servicio por gRPC, recibe el código de estado de la respuesta, agrega los resultados y hace commit del offset en Kafka solo cuando es seguro. El servicio ya no ve particiones ni grupos de consumidores: expone un endpoint gRPC y procesa mensajes.
3. Paralelismo dentro de la partición y commit fuera de orden
Cada partición la sigue leyendo un solo nodo del proxy, pero ese nodo reparte los mensajes en paralelo entre todas las instancias del servicio, así que ya no hace falta una partición por instancia.
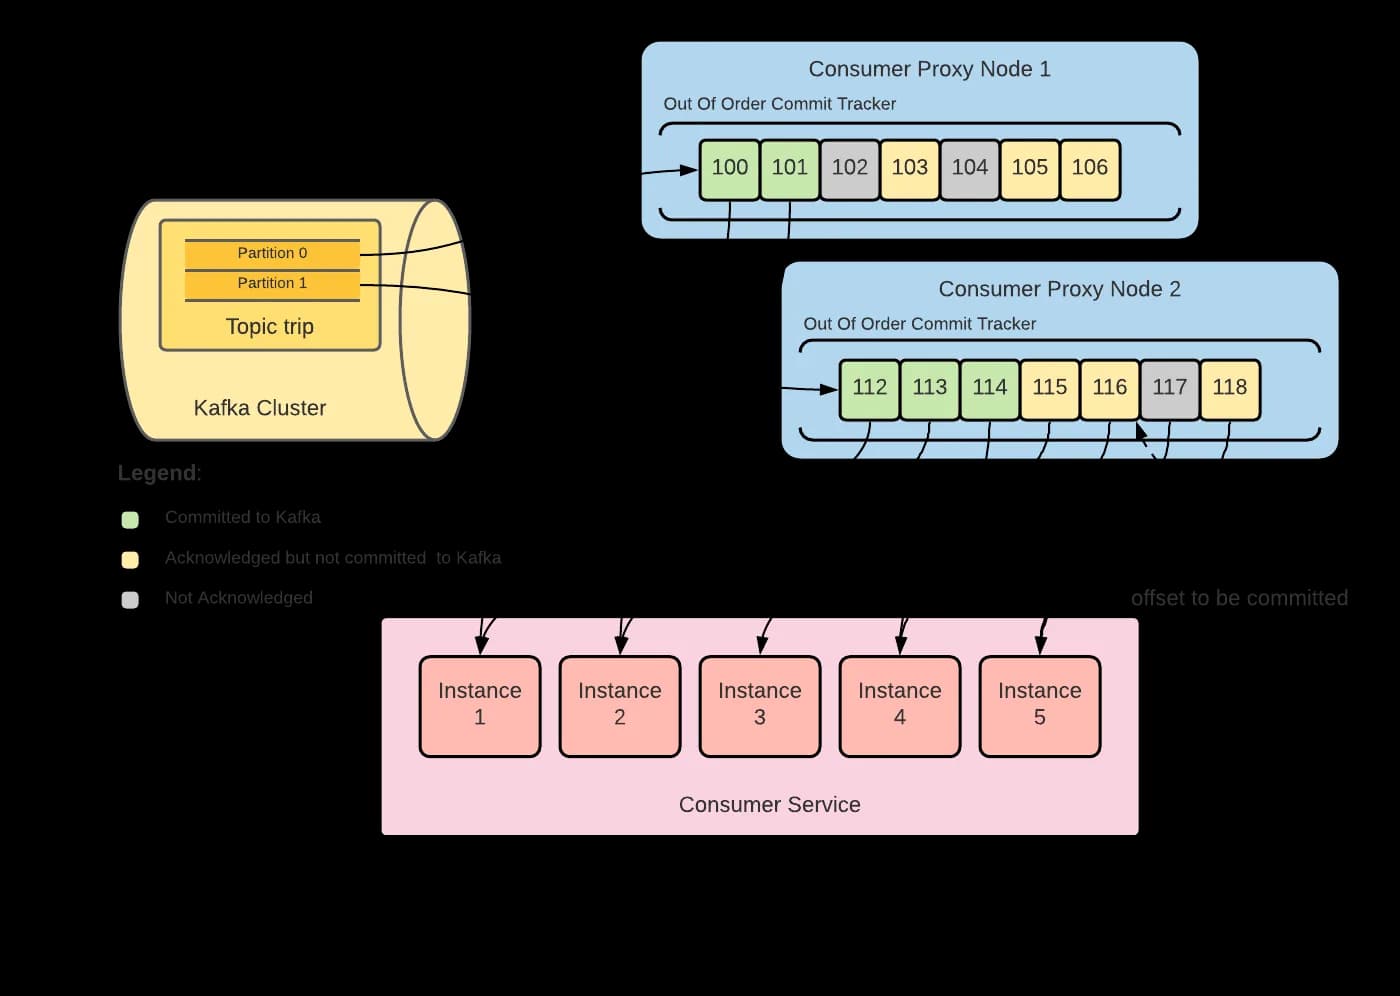
Para que un mensaje lento no frene el siguiente lote, cada mensaje se confirma por separado ante el proxy. Uber lo llama "acknowledge", para distinguirlo del "commit" de Kafka, que implica que todo lo anterior también terminó. El proxy registra los offsets confirmados en un tracker y hace commit en Kafka solo del tramo continuo desde el último commit. La garantía es al menos una entrega: en un rebalanceo puede haber duplicados, que los servicios de Uber ya deduplican.
4. Dead-letter queue y control de flujo
Queda el mensaje veneno: nunca se confirma y bloquea el commit de todo lo que viene después. Para eso está la dead-letter queue (DLQ). El servicio responde con un código de error gRPC, el proxy guarda el mensaje en un topic DLQ, lo marca como confirmado en negativo y el commit sigue avanzando. Después, los equipos pueden reenviar esos mensajes a su servicio (merge) o descartarlos (purge).
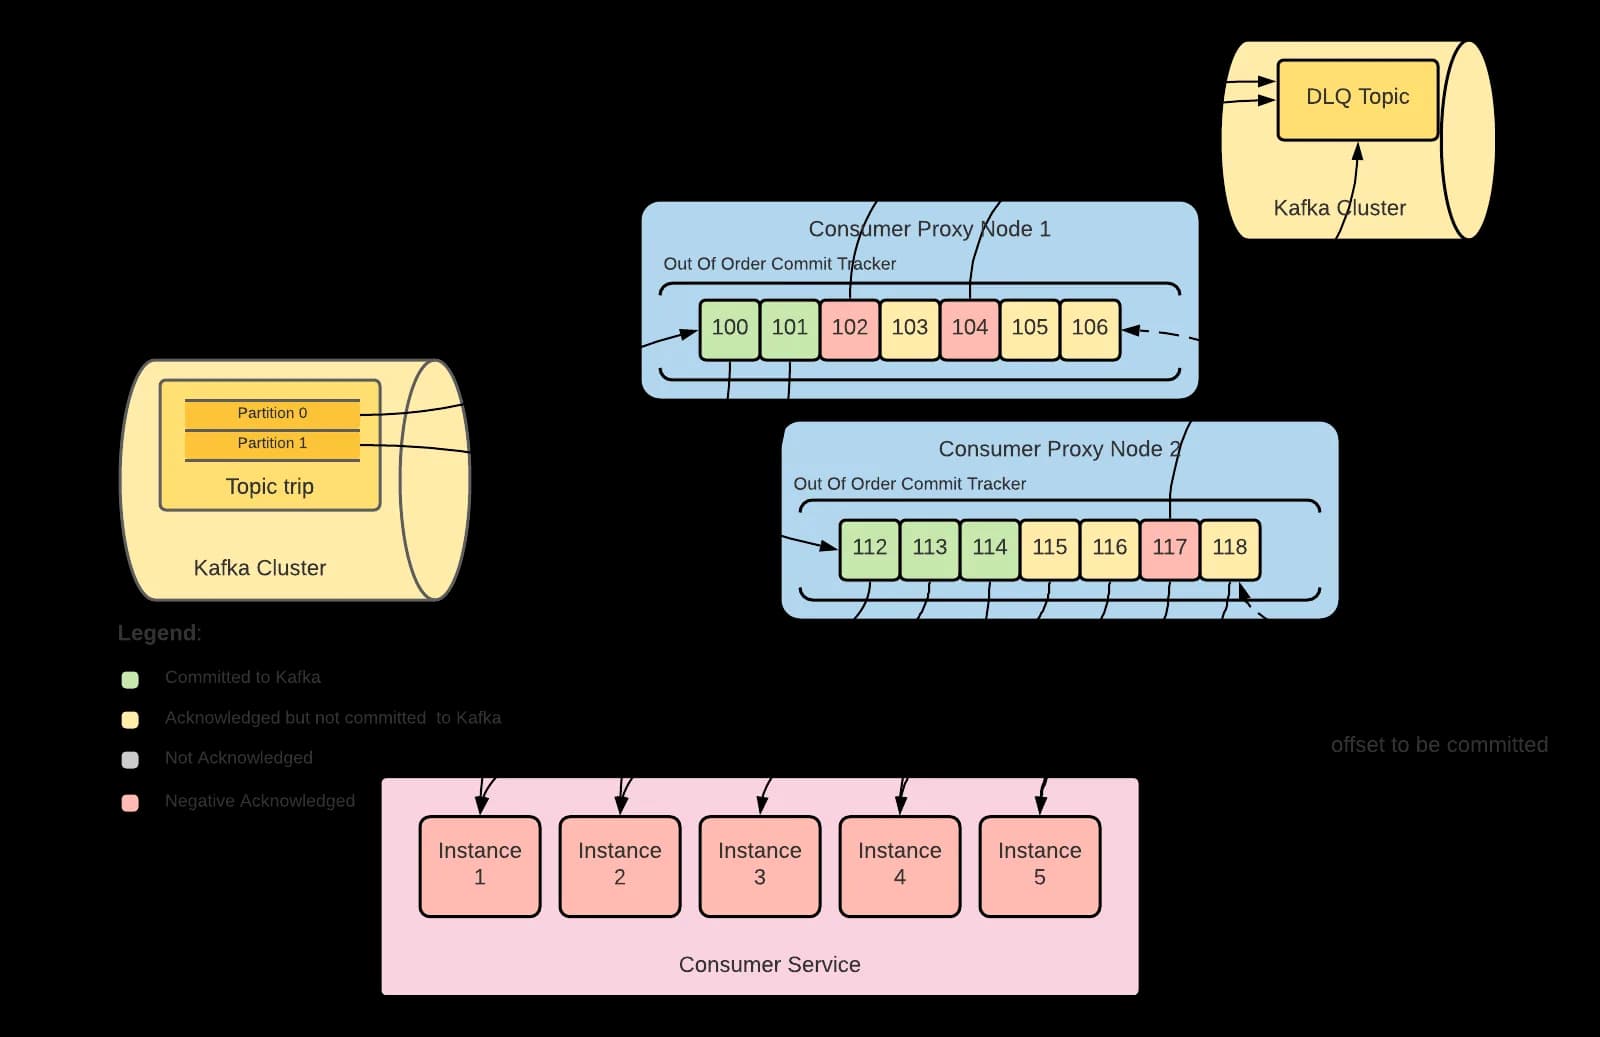
Como el modelo es push, el proxy también regula la velocidad de envío: cada servicio define el tamaño de su tracker y su timeout, el código gRPC de cada respuesta ajusta el ritmo, y un circuit breaker deja de enviar si el servicio está caído, para no llenar la DLQ de mensajes sanos.
5. Lo que apareció con más de 1,000 servicios
El artículo de 2026 cuenta lo que pasó al llevar el proxy a más de 1,000 servicios consumidores. Aparecieron cuatro problemas nuevos: mensajes que se traban antes de llegar al servicio, la necesidad de aislar tráfico, el costo de una flota que pasó de decenas a miles de servidores, y servicios que necesitaban retrasar el procesamiento.
6. Mensajes que no llegan: detección activa del bloqueo
La DLQ funciona si el servicio recibe el mensaje y responde. Hay mensajes que fallan en el camino: los que superan el límite por defecto de 4 MB de gRPC, los que van a instancias específicas que están caídas y los que un interceptor rechaza antes del handler. Ninguno llega a pedir la DLQ, y el consumidor se traba.
Para eso, el proxy mira el tracker. Si le queda espacio, la cola no está bloqueada. Si está lleno, cuenta cuántos mensajes siguen sin confirmar: cuando son pocos y todo lo demás ya está confirmado, lo más probable es que esos pocos estén frenando la cola. En la figura, ese es el caso del tracker B.
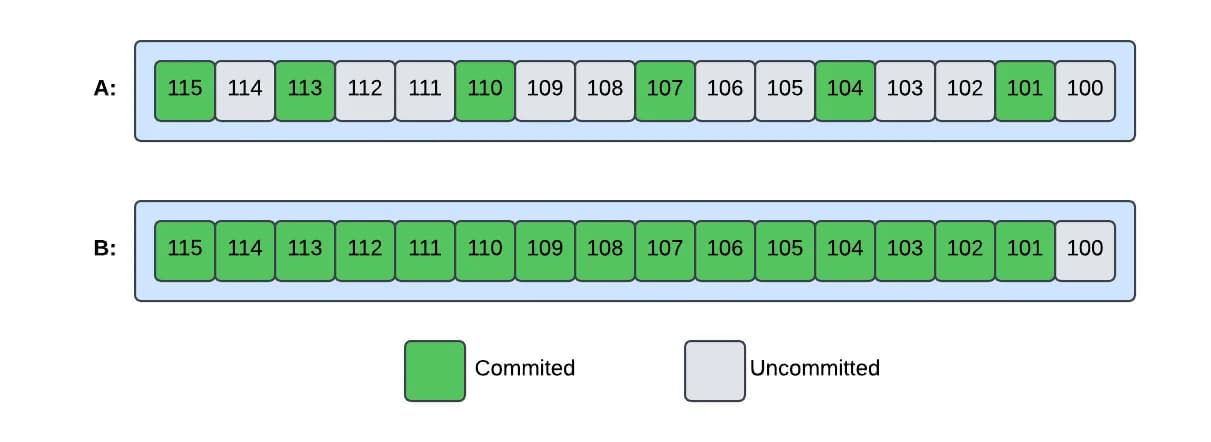
Uber lo da por detectado cuando el tracker supera el 90% de uso y menos del 2% de sus mensajes sigue sin confirmar. Entonces mitiga en cuatro pasos: marca el offset como CANCELED, cancela las peticiones gRPC y sus reintentos, envía el mensaje a la DLQ y lo marca como COMMITTED. La cola vuelve a moverse sin perder el mensaje.
7. Aislamiento con ruteo por contexto
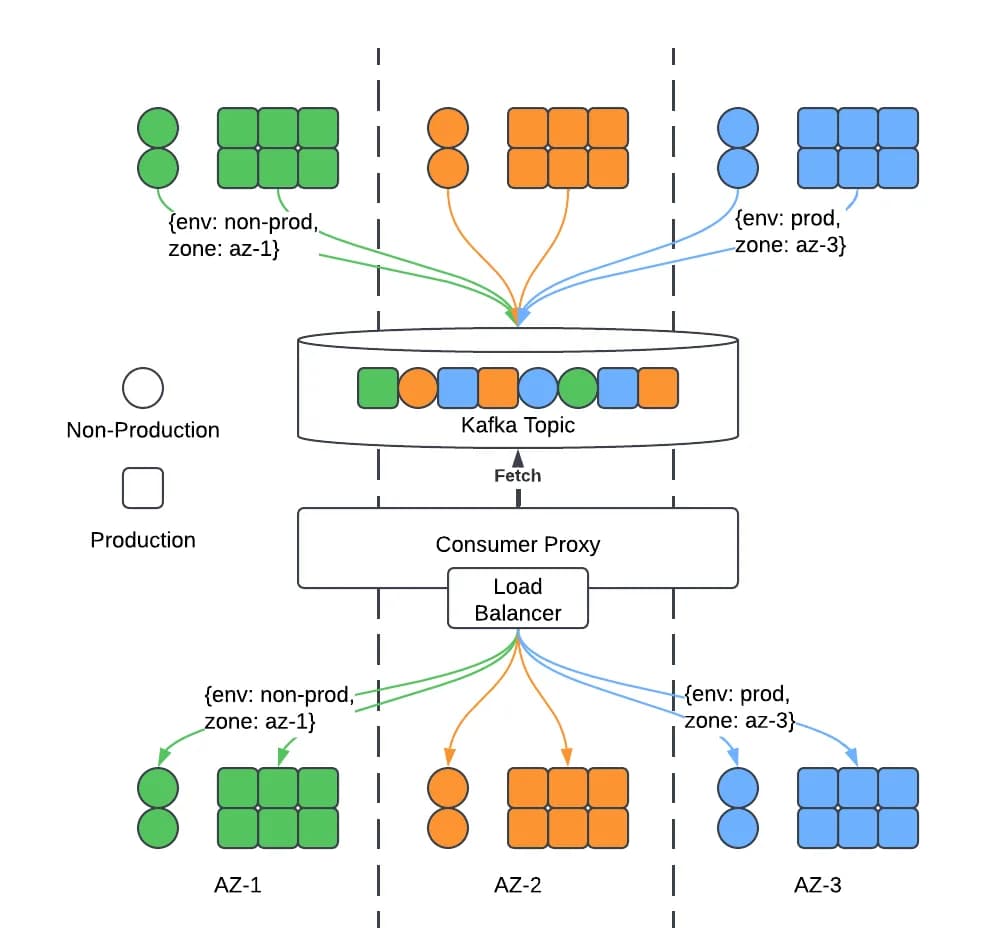
Uber necesitaba dos aislamientos: que los mensajes generados por servicios de no producción no llegaran a servicios de producción, y que la falla de un productor en una zona de disponibilidad no afectara a consumidores de otras zonas. Partir el topic en topics hijos obligaba a cambiar a todos los que ya lo leen, como la analítica y la ingesta de datos.
En cambio, el productor escribe el contexto en un header del mensaje de Kafka (por ejemplo, env: prod y zone: az-3), el proxy lo copia al header de la petición gRPC y el balanceador enruta según ese header.
8. Hardware: cuánto mide cada carga y dónde ubicarla
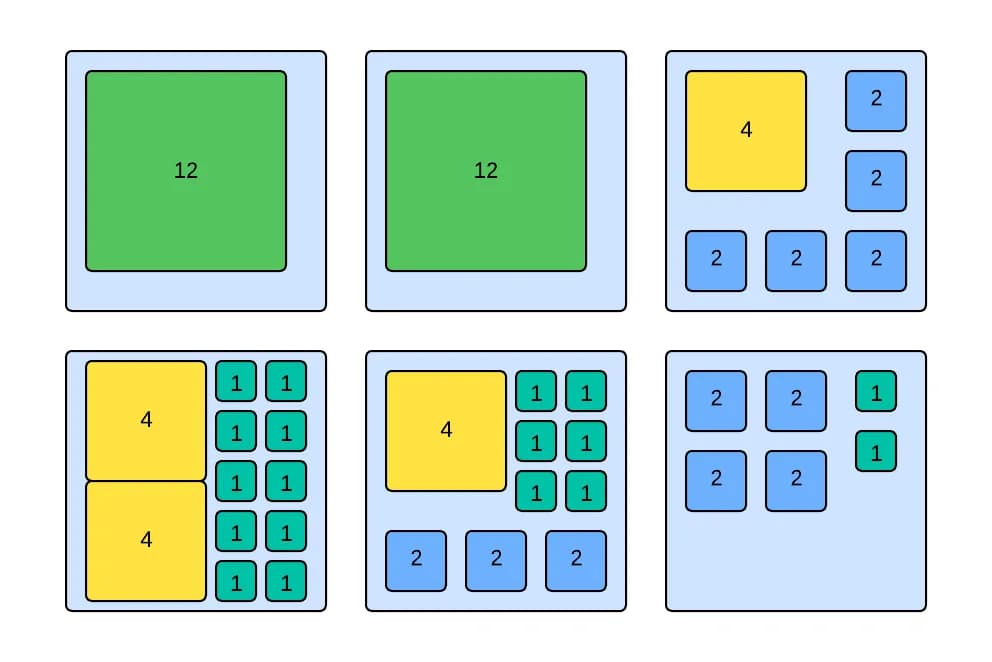
Al quitarles el rebalanceo a los servicios, ese trabajo pasó al proxy, y con la flota en miles de servidores se volvió un problema de costo. El proxy calcula el tamaño de cada carga a partir de sus métricas de tráfico: más peticiones piden más CPU, más concurrencia pide más memoria y más bytes piden más red. Repite el cálculo de forma continua con ventanas distintas para subir y para bajar: escala rápido hacia arriba, para no acumular lag, y lento hacia abajo, para no mover cargas y duplicar mensajes.
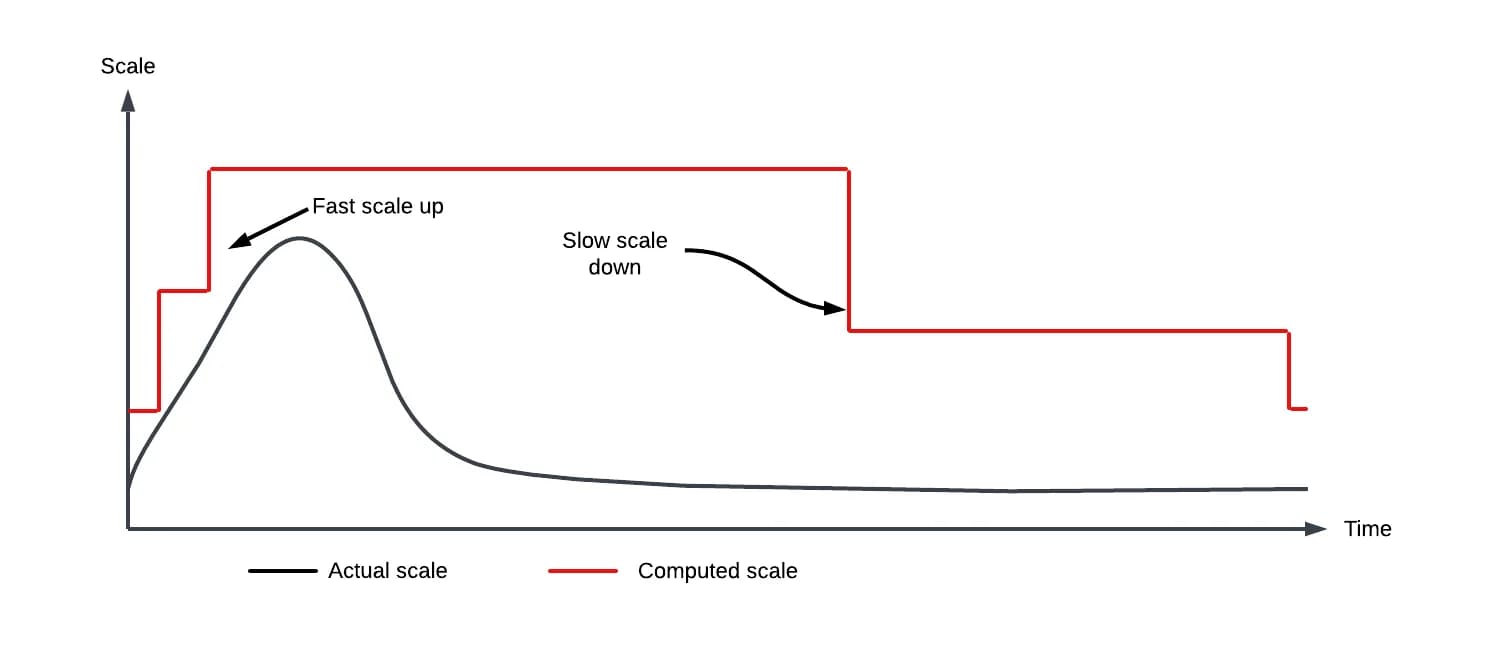
Después ubica esas cargas de tamaños distintos en workers de tamaño fijo, varias por worker mientras la suma quepa. Una vez asignada, la carga se queda en su worker y solo se mueve si deja de caber o si el worker falla su chequeo de vida.
9. Delay processing sin detener el hilo
Algunos servicios recibían eventos antes de que los datos de un sistema externo estuvieran listos, y cada equipo lo resolvía con reintentos propios. El proxy ya soportaba delays en los topics de reintento, pero pausando el hilo lector completo, por lo que esos topics se limitaban a una partición.
La nueva pieza es el DelayProcessManager. Si el primer mensaje pendiente de una partición aún no cumple su delay, pausa solo esa partición y guarda en memoria lo ya leído. Antes de cada lectura, reanuda las particiones que ya lo cumplieron. Las demás particiones del mismo hilo siguen entregando mensajes.
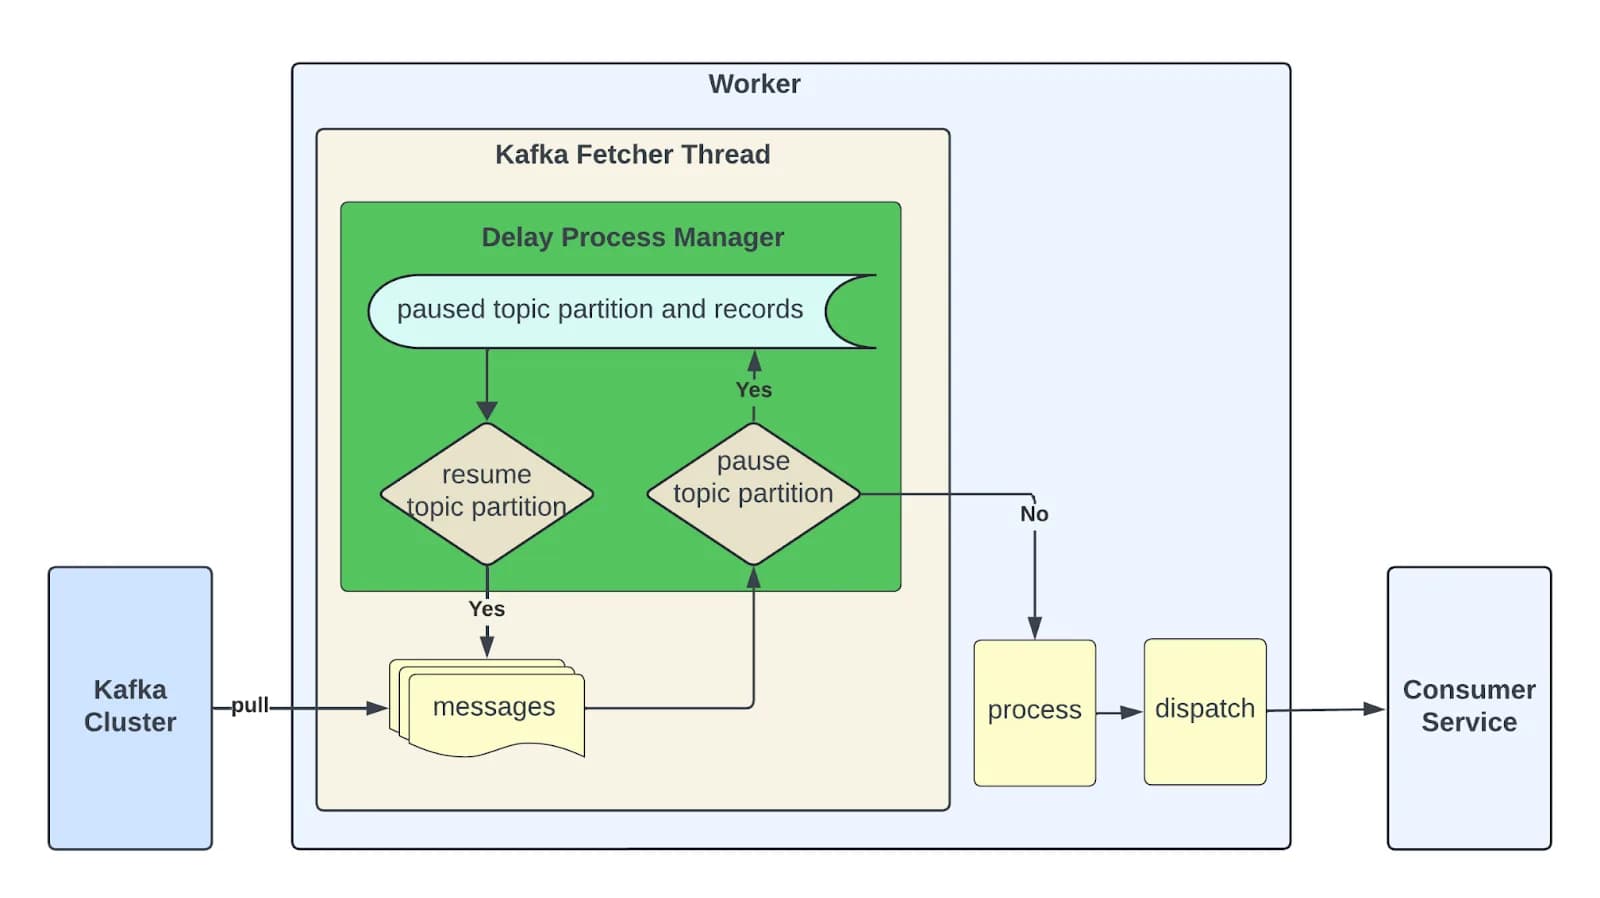
Uber aclara que el delay configurado es un mínimo. Las particiones se reanudan cuando termina el lote en curso, así que si ese lote tarda más que el delay, la espera real también será mayor.
10. Lo que viene
Uber trabaja en dos mejoras: ante el lag, mover el offset al último mensaje y levantar un consumidor lateral que procese lo atrasado; y entregar objetos Protobuf directamente a los servicios, en lugar de bytes crudos de Kafka que cada uno tiene que decodificar.
Qué nos llevamos
De este diseño hay ideas que sirven lejos de la escala de Uber. Separar al que consume del que procesa hace que el número de particiones deje de decidir cuántas instancias pueden trabajar. Confirmar mensajes de uno en uno solo funciona si algo decide qué hacer con los que nunca se confirman; Uber empezó con la DLQ a pedido del servicio y tuvo que sumar la detección automática para los que ni siquiera llegan. Y aislar tráfico con headers evita duplicar topics y tocar a todos los que ya los leen.
Fuentes y créditos
Chen, Z., Yang, Y. y Chen, H. (5 de febrero de 2026). Introducing uFowarder: The Consumer Proxy for Kafka Async Queuing. Uber Engineering Blog. https://www.uber.com/us/en/blog/introducing-ufowarder/
Chu, Q., Teo, G., Zhang, H. y otros (31 de agosto de 2021). Enabling Seamless Kafka Async Queuing with Consumer Proxy. Uber Engineering Blog. https://www.uber.com/us/en/blog/kafka-async-queuing-with-consumer-proxy/
Repositorio uForwarder, licencia Apache 2.0: https://github.com/uber/uForwarder
Todas las figuras son de Uber Technologies Inc. y se reproducen con fines de análisis, con el crédito en cada una. Apache®, Apache Kafka®, Kafka® y gRPC® son marcas registradas de The Apache Software Foundation en Estados Unidos y otros países; su uso no implica respaldo de la fundación.
Más notas del equipo
/ QUIERO ALGO SIMILAR
Tu próximo proyectoempieza hoy.
Cuéntanos qué necesitas — te decimos cómo lo resolvemos, sin vueltas ni letra chica.
Hablemos
O escríbenos directo → hola@identity.pe