
Cómo hablan los microservicios de Netflix, Uber y Airbnb
Detrás de cada pantalla de Netflix o de cada viaje de Uber hay cientos de servicios hablando entre sí. Explicamos las opciones que usan (REST, gRPC, GraphQL, eventos, WebSocket y los protocolos para IA), cuándo conviene cada una y qué publicaron sus equipos técnicos en 2025 y 2026.
Para armar la pantalla de inicio que ves al abrir Netflix, el gateway de su API llegaba a repartir cada consulta en 13 llamadas a otros servicios, en promedio. Uber tiene más de 1,000 servicios que reciben mensajes de una sola plataforma de colas, y en Airbnb más de 130 equipos publican su código en un mismo esquema GraphQL. En sistemas de ese tamaño, cada pantalla y cada pago dependen de que cientos de programas se pidan datos entre sí, casi siempre en milisegundos.
¿Te has preguntado cómo lo hacen? ¿Se hablan todos por una API REST, como la mayoría de las integraciones que conocemos? ¿Usan gRPC, GraphQL, Kafka?
Usan varios a la vez, y cada uno en un lugar distinto del sistema. En este estudio vemos cada opción por dentro, con una animación de cómo viajan los datos, y en cada una revisamos lo que publicaron en 2025 y 2026 los equipos de ingeniería de Uber, Netflix, Airbnb, LinkedIn, Shopify, Stripe y otras empresas. Las fuentes están al final del artículo.
1. Quién habla con quién
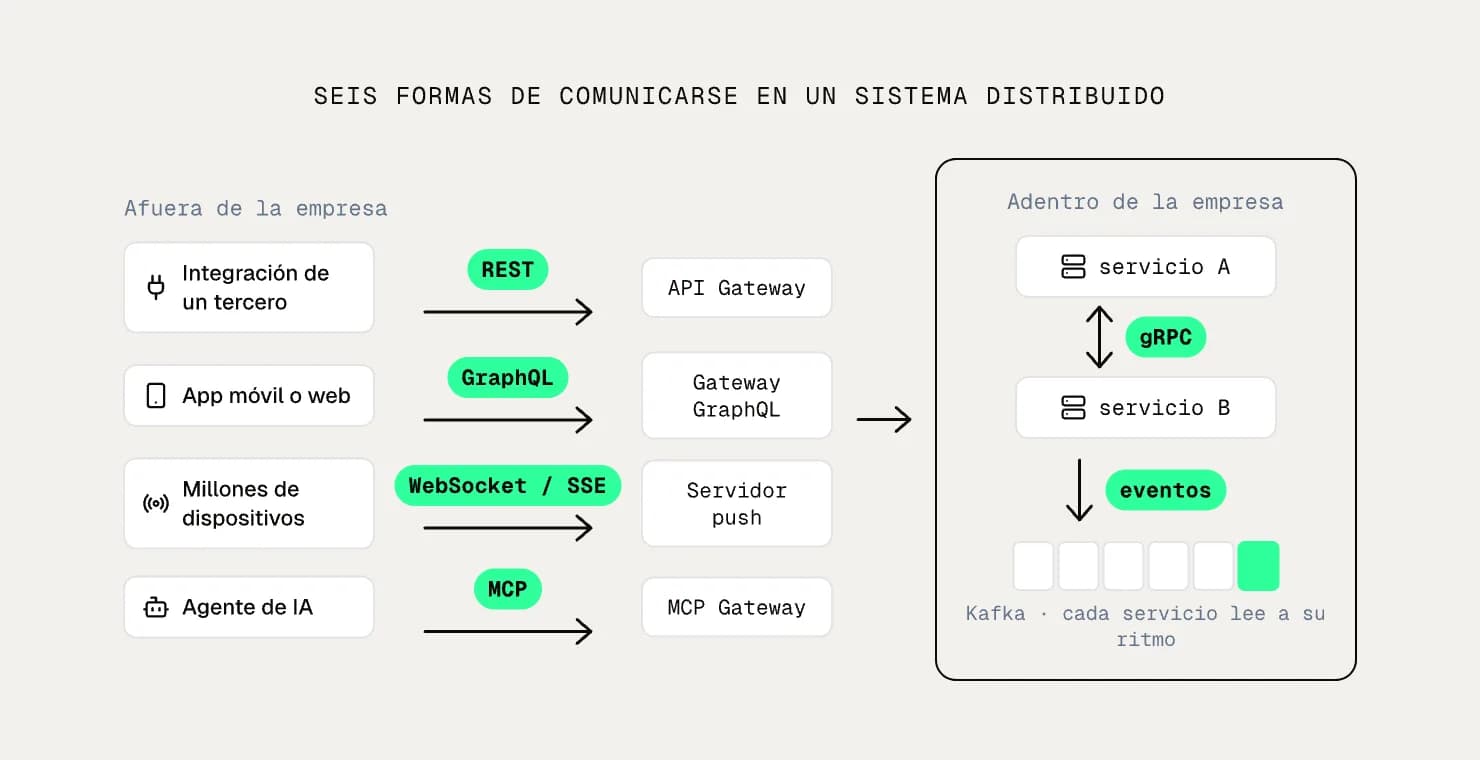
El protocolo depende de dos preguntas: quién está del otro lado y si puede esperar la respuesta. En los sistemas que revisamos se repiten seis situaciones. Un cliente externo usa tu API pública. Un servicio le pide algo a otro dentro de la empresa. Una app necesita armar una pantalla con datos de muchos servicios. Un cambio tiene que llegar a varios sistemas sin que nadie se quede esperando. Un servidor necesita avisar algo a millones de dispositivos al mismo tiempo. Y, desde hace poco, un agente de IA necesita usar las APIs de la empresa.
2. Comunicación pública: REST
REST usa lo que cualquier cliente ya sabe hablar: HTTP y JSON. Una llamada es un request con un método, una ruta, headers y, si hace falta, un cuerpo JSON, por ejemplo POST /v1/pagos con Content-Type: application/json. El servidor contesta con un código de estado (201 si creó el recurso, 404 si no existe, 429 si superaste el límite de requests) y otro JSON. Cada request se entiende solo, sin depender de los anteriores, así que cualquier instancia detrás del balanceador puede atenderlo y las respuestas a un GET se pueden guardar en caché.
El contrato de una API REST suele escribirse en OpenAPI, un archivo que describe cada endpoint, sus parámetros y sus respuestas, y del que se generan la documentación y las librerías cliente. Como del otro lado hay integraciones que tú no controlas, cambiar la API sin romperlas es buena parte del trabajo. Por eso las APIs públicas grandes versionan con fechas en un header y mantienen las versiones viejas durante años.
REST tiene dos costos. JSON es texto: pesa más que un formato binario y hay que convertirlo en cada llamada, algo que se nota cuando el tráfico interno es muy alto. Y una pantalla que necesita datos de varios recursos termina haciendo varias llamadas o recibiendo campos que no usa.

Stripe genera los SDK de sus 7 lenguajes a partir de la especificación OpenAPI de su API y agrupa los cambios incompatibles unas dos veces al año. GitHub publicó en marzo de 2026 una versión nueva de su API REST y garantizó al menos 24 meses de soporte a la anterior, que sigue respondiendo cuando el request no trae el header de versión. Cloudflare describe en OpenAPI una API de más de 2,500 endpoints.
3. Comunicación interna: gRPC
Dentro de la empresa el cliente es otro servicio propio, así que se puede usar algo más estricto y más rápido. gRPC es un framework de llamadas remotas: cada servicio declara en un archivo .proto qué funciones expone y qué mensajes recibe y devuelve, y a partir de ese archivo se genera el código del cliente y del servidor en cada lenguaje. Llamar a otro servicio se parece a llamar a una función local.
Por dentro, gRPC viaja sobre HTTP/2. Cada llamada abre un stream dentro de una conexión que ya está abierta: primero va un frame HEADERS con la ruta (/pagos.Pagos/Cobrar) y los metadatos, después un frame DATA con el mensaje serializado en Protobuf, y la respuesta vuelve por el mismo stream con sus propios HEADERS, los DATA y un trailer con el grpc-status. Como cada stream tiene su número, muchas llamadas viajan intercaladas por la misma conexión sin esperarse entre sí. Cada llamada puede llevar además un plazo máximo (deadline) que se propaga de servicio en servicio.
A cambio, un navegador no lo habla directamente, depurarlo exige herramientas propias y las conexiones largas complican el balanceo de carga: el balanceador elige un servidor al abrir la conexión y después todas las llamadas van al mismo.

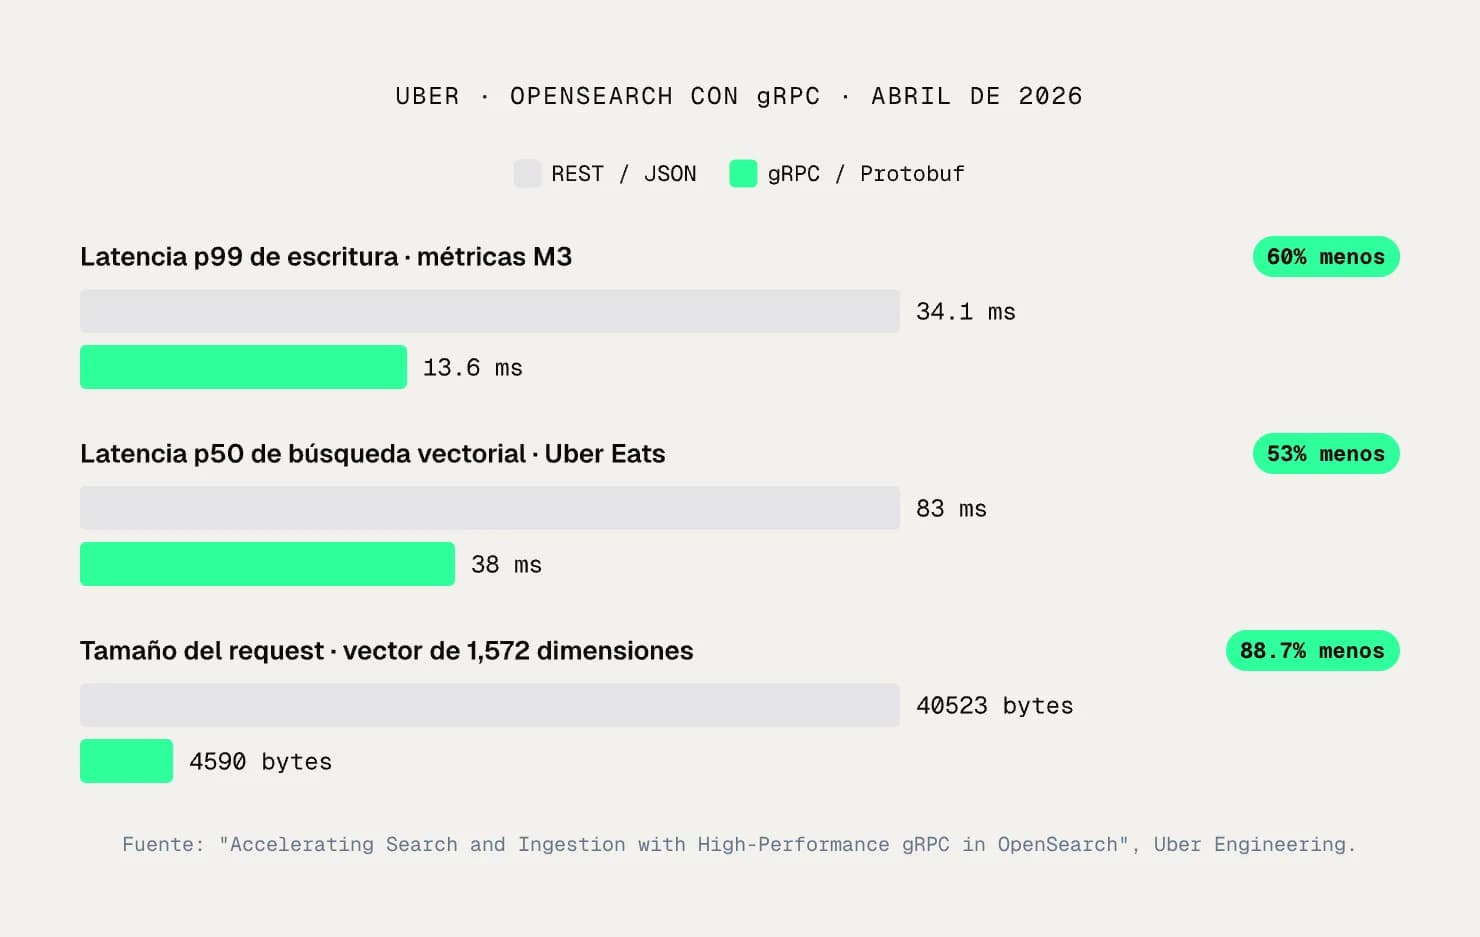
En su artículo sobre uForwarder (febrero de 2026), Uber escribe que gRPC con Protobuf es su protocolo principal para la comunicación entre servicios. En abril de 2026 contó qué pasó al agregar gRPC a OpenSearch, que hasta entonces solo aceptaba REST con JSON: la latencia p99 de escritura de su sistema de métricas bajó de 34.1 a 13.6 ms, la p50 de una búsqueda vectorial de Uber Eats pasó de 83 a 38 ms y un request con un vector de 1,572 dimensiones se redujo de 40,523 a 4,590 bytes. Uber mantuvo REST por compatibilidad.
Netflix responde por gRPC las consultas a su grafo distribuido en tiempo real, decenas de miles por segundo con P99 por debajo de 100 ms en un salto. Databricks corre cientos de servicios gRPC por clúster de Kubernetes y se topó con el problema del balanceo: al repartir la carga desde el cliente en lugar de hacerlo por conexión, redujo alrededor de 20% los pods en varios servicios.
Netflix también documentó un límite. Usaba gRPC entre las etapas de un pipeline que mueve grandes volúmenes de datos agregados y lo cambió por SSE: serializar, manejar conexiones y sostener la memoria consumía más CPU que la lógica del negocio. Su conclusión fue que la recomendación de usar gRPC entre servicios no aplica a todo y que hay que medir antes de asumir.
4. Comunicación con las apps: GraphQL
Una pantalla de una app suele necesitar datos de varios servicios a la vez, como el perfil y las recomendaciones. Con GraphQL la app manda una sola consulta que dice exactamente qué campos quiere y recibe todo en un solo viaje, sin campos de más.
Todas las consultas van por POST a un solo endpoint, /graphql. El servidor valida la consulta contra el esquema, arma un plan y llama a cada servicio que tiene una parte de los datos, en paralelo cuando puede. La respuesta tiene la misma forma que la consulta. Si una parte falla, llegan los datos que sí se obtuvieron junto con una lista de errores. En empresas grandes el esquema se reparte por equipos: en la federación, cada equipo publica su parte en su propio servicio (un subgraph) y un gateway arma la respuesta.
El problema de GraphQL está en lo que pasa detrás de la consulta. Una sola petición puede disparar decenas de llamadas internas, y una consulta mal armada puede consumir muchísimos recursos. Por eso las APIs GraphQL públicas limitan cuánto puede costar cada consulta.

En Netflix, el 85% de las páginas se sirve con GraphQL federado, cerca de un millón de consultas por segundo; bajar el fan-out del inicio de 13 a 2 llamadas redujo cerca de 11% el costo de su flota. Instagram pasó en dos años de desarrollar el 100% de sus APIs en REST a escribir más del 95% de las nuevas en GraphQL. El tráfico de Viaduct, la plataforma GraphQL de Airbnb, creció ocho veces desde 2020, y más del 75% de sus requests vienen de otros servicios internos. Shopify dice que GraphQL es la capa de datos de su comercio y construyó un motor de ejecución nuevo que, en sus pruebas, ejecuta listas grandes hasta 15 veces más rápido.
Booking.com migró de REST con Protobuf a GraphQL porque sus respuestas traían más de 2,500 campos cuando la app usaba unos 100. Como paso intermedio puso un proxy GraphQL delante del backend existente, que seguía calculando todo aunque la app pidiera una parte. Su equipo técnico cuenta que lo que le ayudó el primer año lo frenó el segundo, y que no volvería a construir ese proxy.
5. Comunicación asíncrona: eventos
REST, gRPC y GraphQL son síncronos: quien llama espera la respuesta. Muchas veces no hace falta esperar. Cuando se confirma un pago, el servicio de pagos solo necesita avisar que ocurrió, y después facturación y notificaciones actúan cada una por su cuenta.
Para eso se usan eventos, casi siempre sobre Apache Kafka. El productor envía el evento a un topic, que Kafka divide en particiones. Cada partición es un log que solo crece: el evento nuevo se agrega al final y recibe un número, su offset. Los consumidores de un mismo grupo se reparten las particiones, leen en orden y guardan (commit) el último offset que procesaron. Si un consumidor se reinicia, sigue desde ahí, y un consumidor nuevo puede leer el historial desde el principio.
Los eventos desacoplan a los servicios y absorben picos de tráfico, pero el sistema pasa a ser eventualmente consistente: durante un momento, cada servicio puede tener una versión distinta de los datos. Además, cada evento necesita un contrato (su esquema) y el broker es un sistema más que hay que operar.

LinkedIn mueve más de 32 billones de registros al día en 400,000 topics y tuvo que construir su propio sistema de logs (Northguard) cuando operar Kafka a esa escala se volvió el problema. Netflix explica por qué pasó de escribir en varias bases de forma síncrona a escribir primero en un log: una falla a mitad de camino dejaba datos inconsistentes. Airbnb pone Kafka delante de su nueva base clave-valor para absorber picos de escritura, y con ese esquema migró más de un petabyte sin tiempo fuera de servicio. En banca, Nubank procesa 72 mil millones de eventos diarios por Kafka entre más de 4,000 microservicios.
Zalando usaba un flujo de eventos como la única forma de leer precios y stock. En Cyber Week los eventos llegaban hasta 30 minutos tarde, más del 90% de cada mensaje repetía datos que no habían cambiado y cada equipo terminaba con su propia copia. Lo reemplazó por una API de lectura que hoy atiende millones de requests por segundo con latencias de pocos milisegundos, y los eventos siguen alimentando esa API.
6. Tiempo real: WebSocket y SSE
En HTTP normal el cliente pregunta y el servidor responde; si el servidor necesita avisar algo, el cliente tendría que preguntar cada pocos segundos. WebSocket empieza como un request HTTP con el header Upgrade: websocket. El servidor contesta 101 Switching Protocols y desde ahí la conexión queda abierta y los dos lados se mandan frames cuando quieren. Server-Sent Events (SSE) es más simple: el cliente hace un GET y el servidor responde con Content-Type: text/event-stream sin cerrar la respuesta. Cada evento es una línea que empieza con data:, y así muestran los chatbots su respuesta palabra por palabra.
Las conexiones abiertas tienen estado. El balanceador tiene que mandar a cada cliente siempre al mismo servidor, y si millones de dispositivos se reconectan a la vez, pueden tumbar al servicio.

Durante sus eventos en vivo, Netflix envía actualizaciones a más de 100 millones de dispositivos en menos de un minuto por WebSocket. Para que no pidan todos los datos al mismo tiempo, primero precarga los datos pesados y después manda un mensaje pequeño que dice cuándo usarlos. OpenAI pasó los loops de sus agentes de peticiones HTTP sueltas a una conexión WebSocket que guarda el estado, y con ese cambio y otras optimizaciones los hizo 40% más rápidos de punta a punta.
7. Comunicación con modelos de IA: MCP y A2A
Los agentes de IA también necesitan llamar a las APIs de la empresa. MCP (Model Context Protocol) es un protocolo abierto que usa JSON-RPC: el agente pide la lista de herramientas (tools/list), el servidor la devuelve con los parámetros de cada una y, cuando el modelo decide usar una, el agente envía tools/call con los argumentos. A2A (Agent2Agent) cubre otro caso, el de un agente que le delega trabajo a otro.
Son protocolos jóvenes y todavía cambian. La especificación de MCP de 2026 eliminó las sesiones para que un servidor MCP escale como cualquier servicio HTTP, y dejó obsoleto el transporte anterior basado en SSE.

Uber habilitó MCP sobre las APIs existentes de sus miles de servicios, con un gateway central por el que pasa cada llamada de sus agentes. Cloudflare usa la especificación OpenAPI de su API para que un agente la opere entera con unos 1,000 tokens de contexto, en lugar de los 1.17 millones que ocuparía describir cada endpoint como herramienta.
8. Comparación: cuál conviene en cada caso
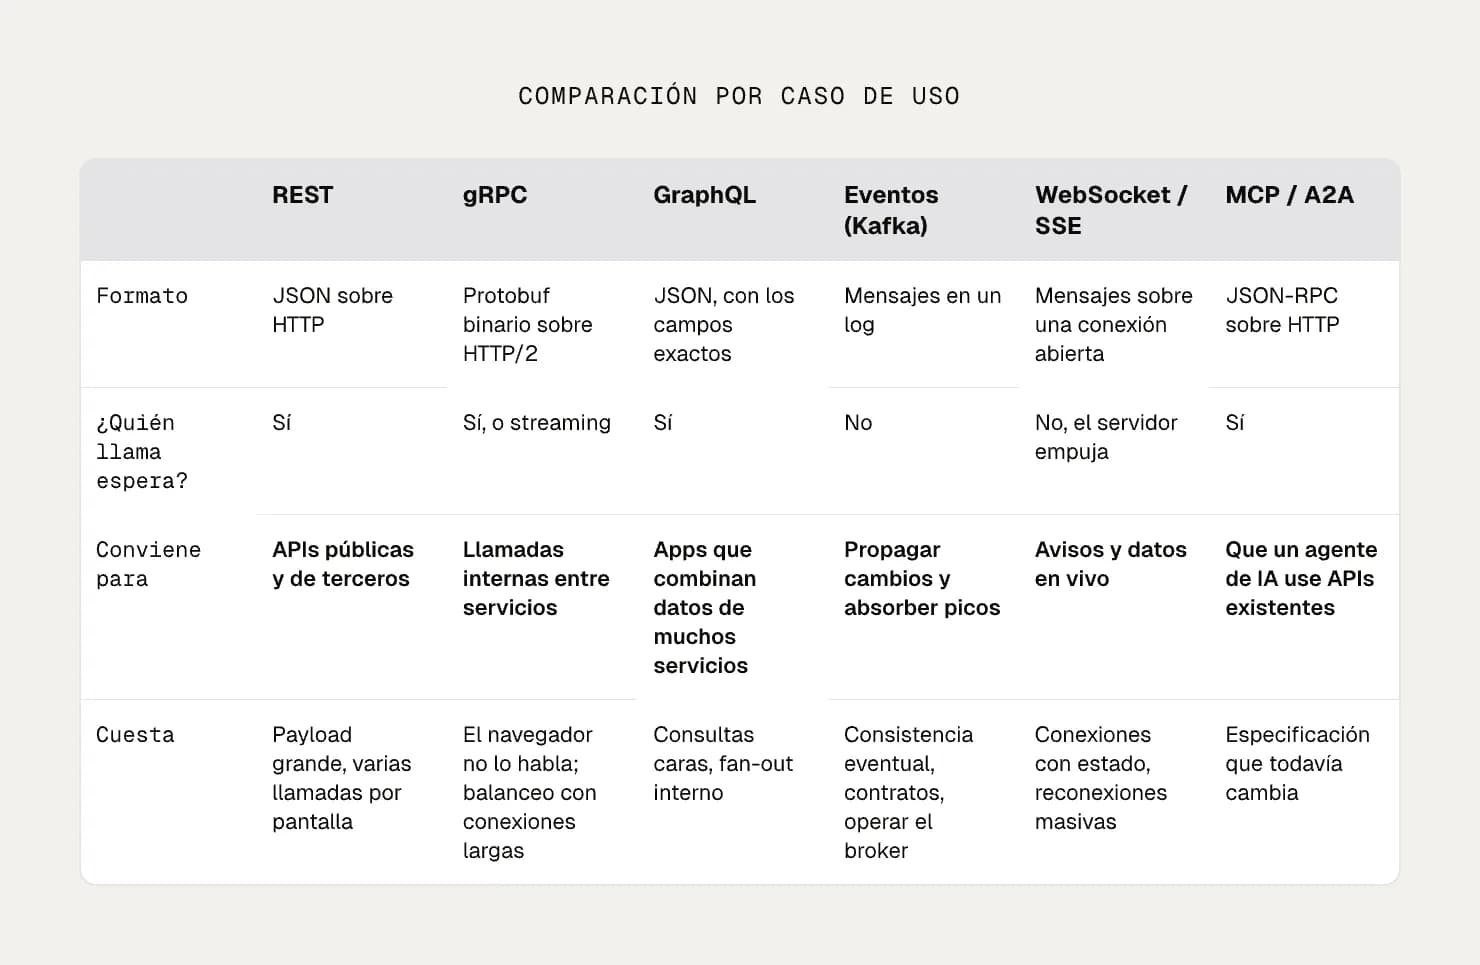
La tabla resume las seis opciones. REST conviene cuando del otro lado hay alguien que no controlas. gRPC, cuando ambos lados son tuyos y la latencia o el volumen importan. GraphQL encaja cuando una app necesita armar pantallas con datos de muchos servicios, y los eventos cuando un cambio tiene que llegar a varios sistemas sin que nadie espere. WebSocket y SSE sirven para que el servidor avise primero, y MCP y A2A para que un agente de IA use lo que ya existe.
9. Entonces, ¿cómo se comunican?
Con varios protocolos, cada uno donde rinde más. Uber, Netflix y Airbnb exponen REST hacia afuera, usan gRPC entre sus servicios, arman las pantallas con GraphQL, propagan los cambios con eventos, avisan a los dispositivos por WebSocket y ya conectan a sus agentes de IA con MCP.
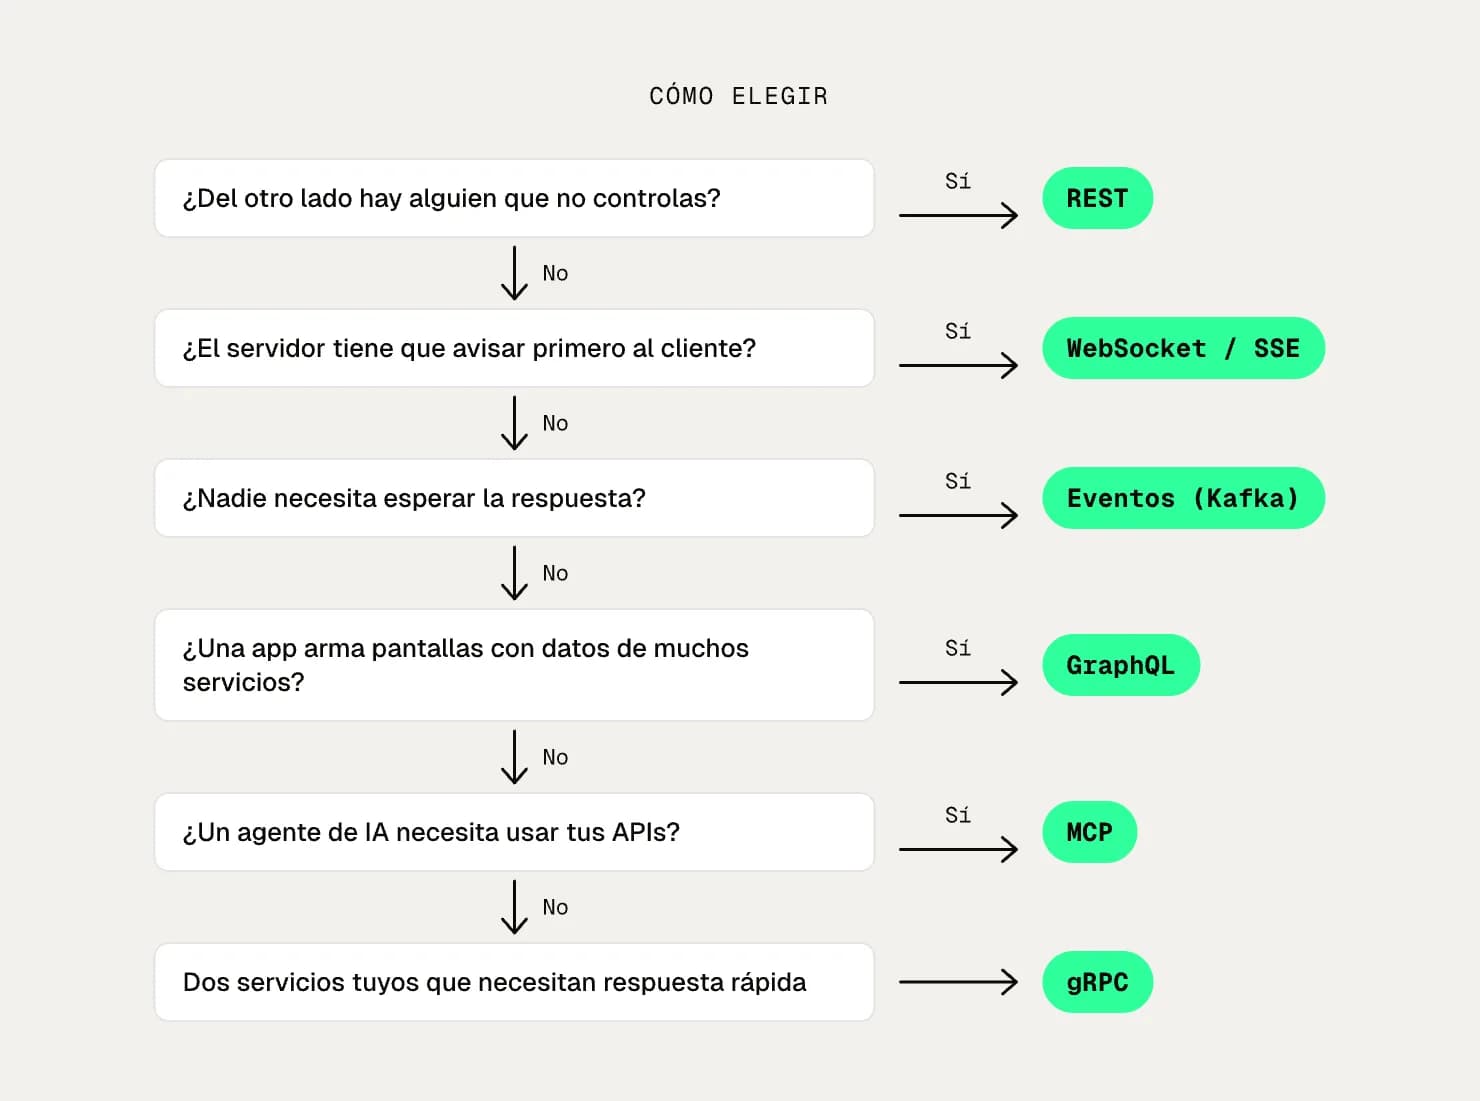
Para elegir en un sistema propio sirven las dos preguntas del principio. Si del otro lado hay alguien que no controlas, REST. Si son dos servicios tuyos que necesitan respuesta rápida, gRPC. Si la app arma pantallas con datos de muchos lugares, GraphQL. Si nadie necesita esperar, un evento. Si el servidor tiene que avisar primero, WebSocket o SSE.
Los casos de Netflix, Zalando y Booking.com apuntan a lo mismo: antes de cambiar de protocolo conviene medir cómo se está usando el actual. Las 13 llamadas del inicio de Netflix bajaron a 2 con el mismo protocolo: su equipo cambió cómo el gateway planificaba cada consulta.
Si te interesa ver uno de estos patrones en detalle, en nuestro estudio sobre uForwarder explicamos cómo Uber combina Kafka y gRPC para usar Kafka como cola de mensajes.
Fuentes y créditos
Uber Engineering: "Introducing uFowarder: The Consumer Proxy for Kafka Async Queuing" (Chen, Yang y Chen, 5 feb 2026); "Accelerating Search and Ingestion with High-Performance gRPC in OpenSearch" (Xu, Lu y Zhang, 14 abr 2026); "Solving the Identity Crisis for AI Agents" (Mathew y otros, 21 may 2026).
Netflix TechBlog: "Building a Resilient Data Platform with Write-Ahead Log at Netflix" (Karumanchi y otros, 26 sep 2025); "Behind the Streams: Real-Time Recommendations for Live Events, Part 3" (Range y otros, 21 oct 2025); "Building Service Topology at Scale" (Jain y otros, 13 jul 2026); "How and Why Netflix Built a Real-Time Distributed Graph, Part 3" (Mishra y Koti, 7 ago 2026). En GraphQLConf 2025: "GraphQL Performance Issues at Netflix Scale" (Chambers, 8 sep 2025).
Airbnb Tech Blog: "Viaduct, Five Years On" (septiembre de 2025) y "Building a Next-Generation Key-Value Store at Airbnb" (Gaonkar, Rangarajan y Zhang, 24 sep 2025). LinkedIn Engineering: "Introducing Northguard and Xinfra" (Karaman y Wu, 25 jun 2025). Shopify Engineering: "Shopify's journey to faster breadth-first GraphQL execution" (MacWilliam, 12 mar 2026).
Stripe: "How API changes flow into Stripe's developer products" (Mello y Mason, 15 jun 2026) y "Introducing Stripe's new public preview release channel" (Anderson, 7 may 2025). GitHub Changelog: "REST API version 2026-03-10 is now available" (12 mar 2026). Cloudflare: "Code Mode: give agents an entire API in 1,000 tokens" (Carey, 20 feb 2026) y "The next generation of MCP" (Carey, 6 ago 2026). OpenAI: "Speeding up agentic workflows with WebSockets in the Responses API" (Yu y Nathan, 22 abr 2026).
Databricks: "Intelligent Kubernetes Load Balancing at Databricks" (Nanda, Cheng y Agrawal, 1 oct 2025). Building Nubank: "Managing Cloud Limits" (Peixoto y Dantas, 9 abr 2025). Zalando Engineering: "From Event-Driven Chaos to a Blazingly Fast Serving API" (Gallagher y Carta, 7 mar 2025). GraphQLConf 2025: "Instagram's REST To GraphQL Migration" (Han y otros, 10 sep 2025) y "Breaking the Monolith: Our Journey From Proto To Federated GraphQL at Scale" (Mittal, Booking.com, 10 sep 2025).
Los diagramas y animaciones son de idtt. El gráfico de latencias y tamaño de request usa los datos del artículo de Uber sobre gRPC en OpenSearch.
Más notas del equipo
/ QUIERO ALGO SIMILAR
Tu próximo proyectoempieza hoy.
Cuéntanos qué necesitas y te decimos cómo lo resolveríamos.
Hablemos
O escríbenos directo → hola@identity.pe