
Cuándo usar Kubernetes: lo que muestran diez caídas
Roblox, Datadog y Skyscanner se cayeron por un cambio propio en la capa que gestiona sus contenedores. Leímos diez postmortems y los casos de quienes subieron o bajaron de herramienta para responder cuándo usar Docker Compose, Swarm o Kubernetes.
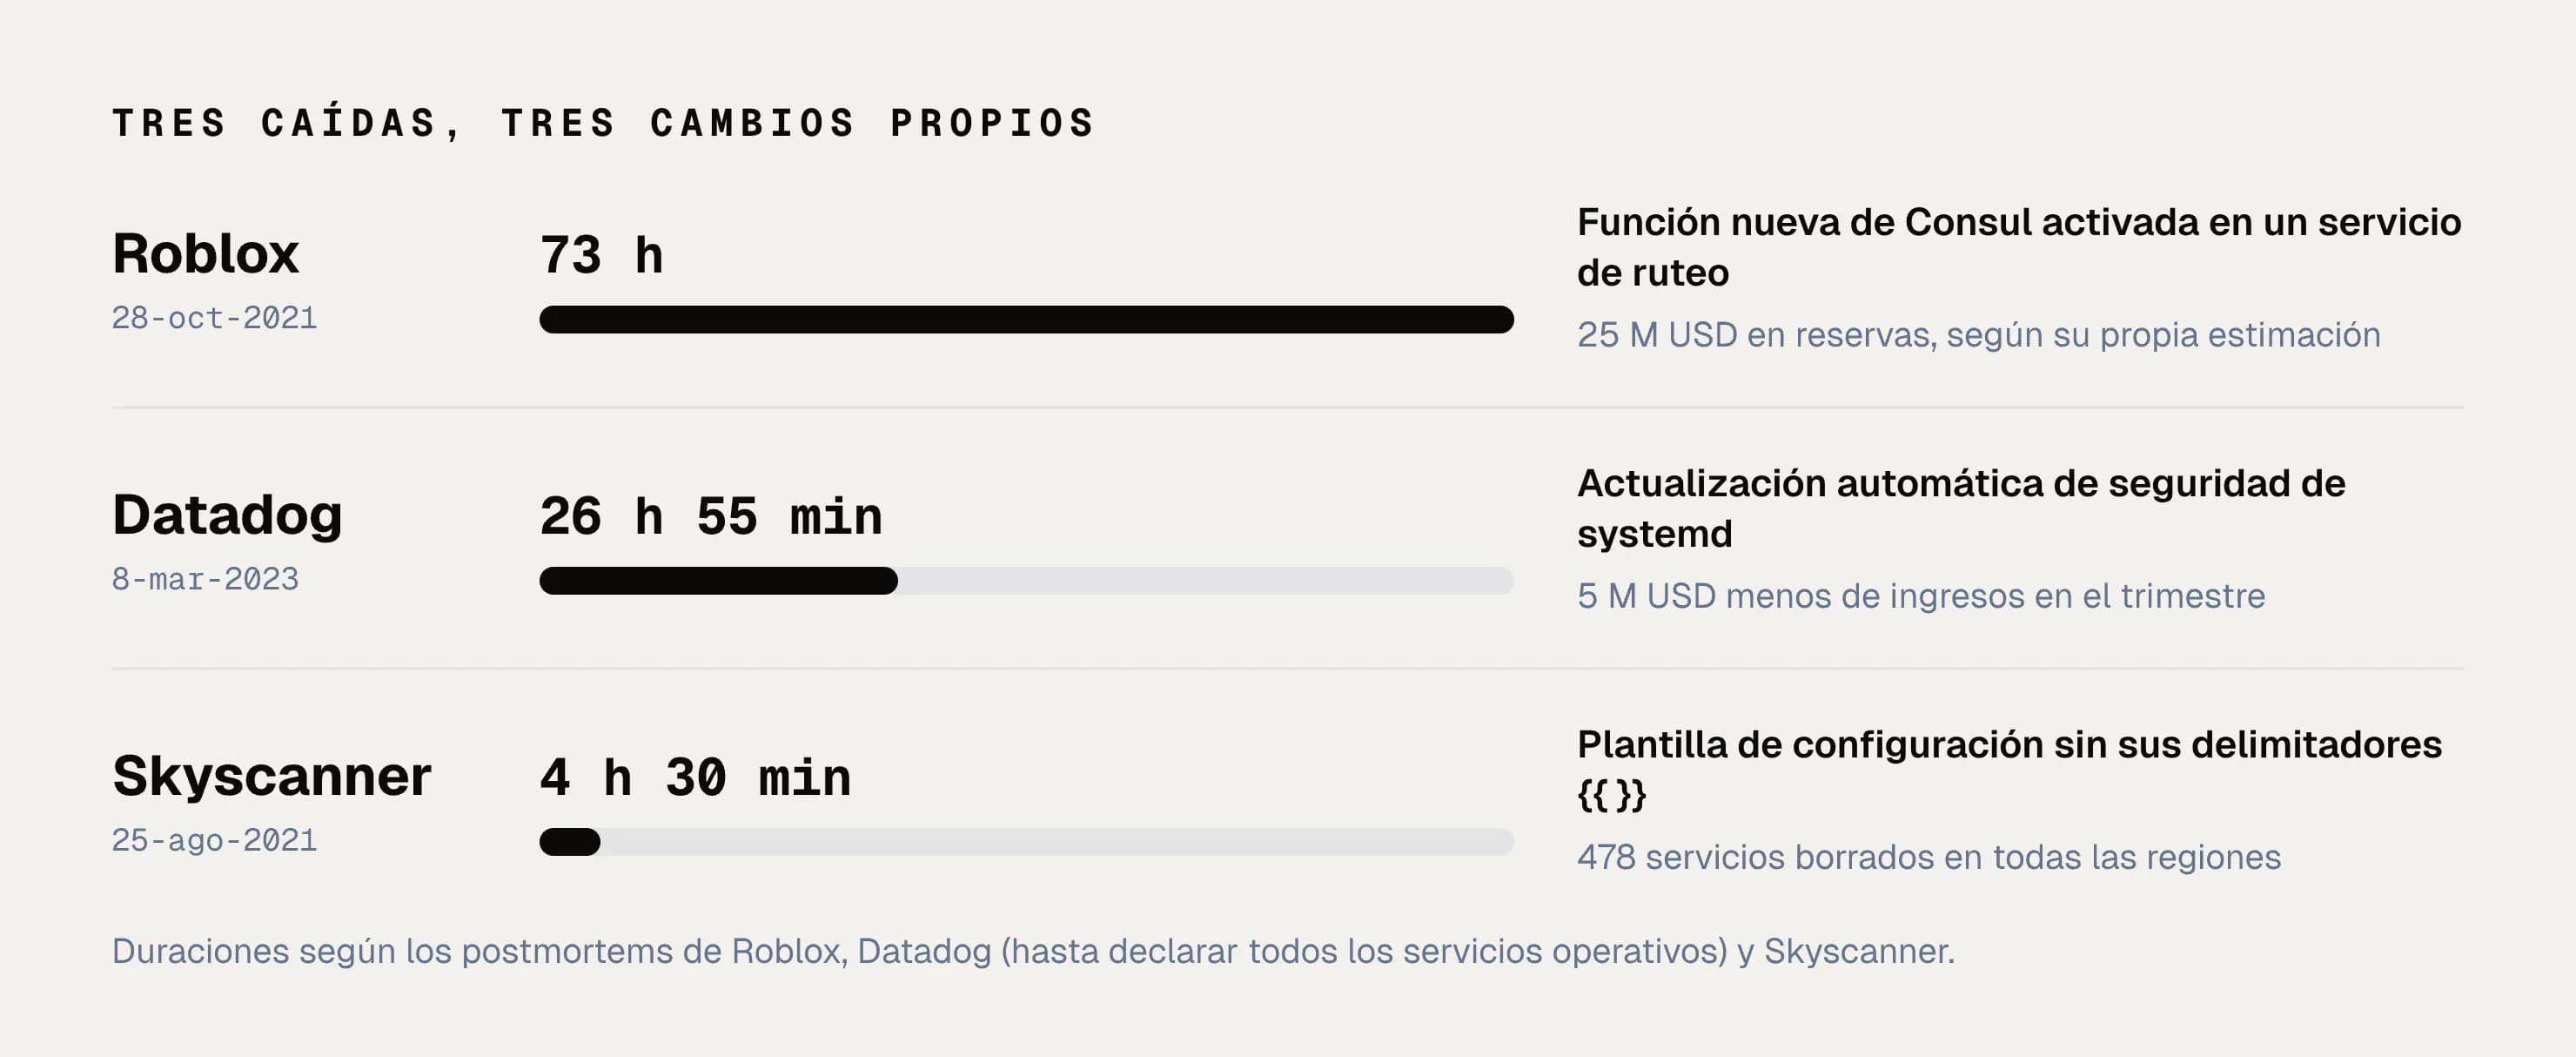
El 28 de octubre de 2021 Roblox se apagó y tardó 73 horas en volver. El 8 de marzo de 2023 Datadog perdió la red en entre el 50 y el 60 % de sus nodos de Kubernetes, y sus directivos calcularon después que la caída le restó unos 5 millones de dólares a los ingresos del trimestre. El 25 de agosto de 2021 Skyscanner borró 478 servicios en todas sus regiones porque a una plantilla le faltaba un par de caracteres.
En ninguna de las tres hubo un pico de usuarios ni un ataque. Las tres empezaron con un cambio que hizo la propia empresa en la capa con la que gestiona sus contenedores. Leímos los postmortems originales de diez incidentes de este tipo, y los relatos de empresas que cambiaron de herramienta, para responder una pregunta práctica: cuándo usar Docker Compose, Swarm o Kubernetes según la volumetría y la complejidad de cada equipo.
1. Tres caídas que nadie provocó desde afuera
Roblox corre en centros de datos propios, con más de 18,000 servidores y 170,000 contenedores. Los orquesta con Nomad y usa Consul para que los servicios se encuentren entre sí. Un día antes de la caída activó una función nueva de Consul en un servicio de ruteo de tráfico. Con la carga de Roblox, esa función y un problema de rendimiento en la base de datos interna de Consul dejaron al clúster sin responder. Todos los servicios de backend dependían de ese único clúster, incluida la telemetría que habría servido para diagnosticarlo: catorce horas después del inicio, el equipo todavía no sabía qué fallaba. Su postmortem concluye que Consul era un punto único de falla. Roblox estimó en 25 millones de dólares las reservas que dejó de recibir.
En Datadog, una actualización automática de seguridad de systemd se aplicó a las 06:00 UTC. Al reiniciarse el servicio de red, borró las rutas que gestionaba Cilium, el componente que conecta los contenedores entre sí. Las regiones de Datadog no comparten red ni plano de control. Compartían la imagen del sistema operativo, con la misma ventana de actualización por defecto, entre las 06:00 y las 07:00 UTC, y cayeron las cinco a la vez. Todos los servicios volvieron a estar operativos al día siguiente, a las 08:58 UTC.
En Skyscanner, un cambio pensado para no alterar nada pasó la revisión de pares y se desplegó solo. Al archivo le faltaban los delimitadores {{ }} de una plantilla. Estaba en la raíz de la configuración regional, así que el sistema lo distribuyó a todo el mundo de inmediato. Argo CD, la herramienta que mantiene cada clúster igual a lo que dice el repositorio, hizo lo que se le pidió y borró los 478 servicios. El sitio y las apps estuvieron caídos cuatro horas y media.
2. Qué es la orquestación de contenedores
La orquestación de contenedores es el trabajo de decidir en qué máquina corre cada contenedor, reiniciarlo si se cae, conectarlo con los demás y actualizarlo sin cortar el servicio. Con un contenedor en un servidor, ese trabajo lo hace una persona con un comando. Con miles, lo hace un software, el orquestador.
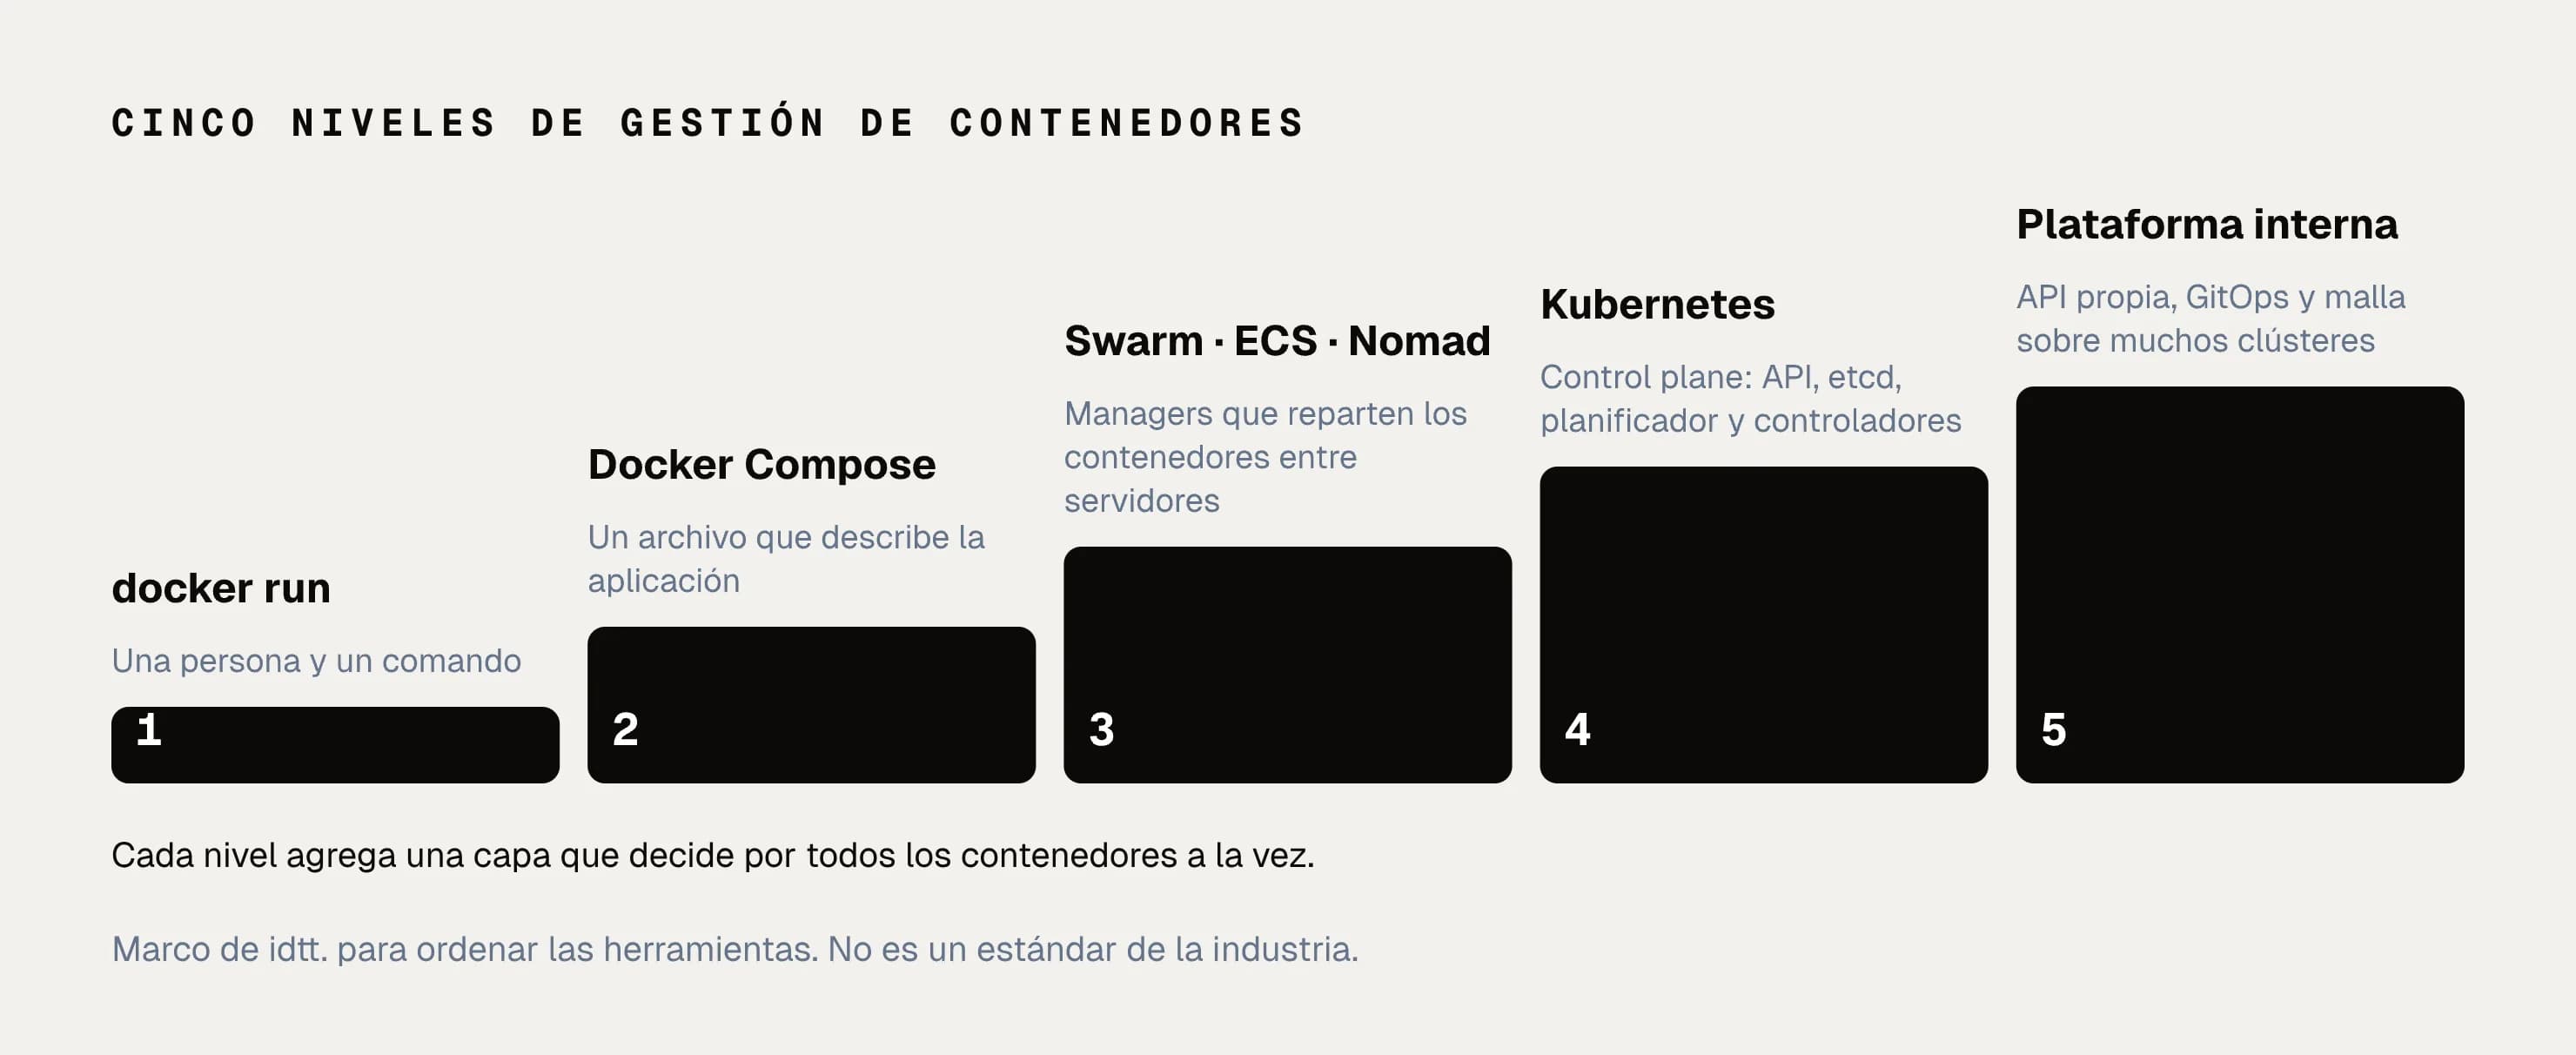
Para ordenar las herramientas usamos cinco niveles. Es un marco nuestro: la industria no tiene un nombre estándar para esta progresión. Los dos primeros son un servidor con Docker, a mano o con Docker Compose. El tercero reparte los contenedores entre varios servidores con un orquestador sencillo, como Docker Swarm, Amazon ECS o Nomad. El cuarto es Kubernetes. El quinto es la plataforma interna que las empresas grandes construyen encima de Kubernetes.
Cada nivel agrega una capa que decide por todos los contenedores a la vez. Esa capa se llama control plane, o plano de control, y lo que alcanza a romper cuando falla se llama blast radius. AWS describe el plano de control como la maquinaria que hace los cambios en un sistema, y el plano de datos como el trabajo diario de lo que ya está corriendo. Sus ingenieros observan además que el plano de control tiene más piezas móviles que el de datos y que, solo por eso, es más probable que falle.
3. Niveles 1 y 2: un servidor con Docker y Docker Compose
Docker Compose define en un archivo todos los contenedores de una aplicación y los levanta juntos. La documentación de Docker lo da por válido en producción y dice que la forma más sencilla de desplegar es en un solo servidor. Para crecer, remite a Swarm.
Su alcance práctico es ese servidor. Si la máquina se cae, se cae todo lo que corre en ella. El blast radius es total, pero es pequeño y conocido: una máquina y un archivo que el equipo entiende completo.
No encontramos ningún postmortem público, con nombre de empresa, de una caída causada por Compose. Puede deberse a que quien opera a esa escala rara vez publica postmortems, así que no lo tomamos como prueba de que sea más seguro.
4. Nivel 3: Swarm, ECS y Nomad
Docker Swarm une varios servidores en un clúster, con réplicas y actualizaciones graduales. Su documentación explica qué pasa si se pierde el quórum de los nodos que lo administran: los contenedores que ya corrían siguen corriendo, pero no se puede agregar, actualizar ni mover nada. El clúster sigue en pie y queda congelado, que es como se ve un plano de control caído.
OneLogin eligió Swarm porque era lo que menos trabajo pedía para empezar, y en octubre de 2019 tenía más de 1,300 contenedores en producción. Para llegar ahí construyó sus propias herramientas de autoescalado, de configuración y de administración del clúster. Cuando Mirantis compró el negocio empresarial de Docker y se anunció el fin de vida de Swarm, OneLogin decidió migrar a Kubernetes en AWS. Mirantis retiró después ese anuncio, y en julio de 2025 se comprometió a dar soporte a Swarm hasta al menos 2030 dentro de su producto comercial.
Figma usaba Amazon ECS y le quedó corto en dos puntos concretos. ECS no tiene StatefulSets, la pieza de Kubernetes que da identidad persistente a un contenedor, y para correr etcd tuvo que envolver código propio que resultó frágil y difícil de mantener. Tampoco podía instalar software empaquetado con Helm. Migró la mayoría de sus servicios principales a Kubernetes en menos de 12 meses.
La caída de Roblox pertenece a este nivel. Nomad se ocupa solo de programar las cargas y se apoya en Consul para el descubrimiento de servicios, y Roblox tenía un solo clúster de Consul para todo. Después del incidente repartió los servicios críticos en clústeres dedicados y sacó la telemetría de esa dependencia.

5. Nivel 4: Kubernetes y su control plane
El glosario de Kubernetes define el control plane como la capa de orquestación que expone la API para definir, desplegar y gestionar el ciclo de vida de los contenedores. Sus piezas principales son el servidor de API, la base de datos etcd, el planificador y los controladores. Según la encuesta anual de la CNCF publicada en enero de 2026, el 82 % de quienes usan contenedores corre Kubernetes en producción.
Respecto al nivel 3 agrega un ecosistema: almacenamiento con identidad persistente, autoescalado y herramientas de terceros que se instalan con un comando. También agrega un calendario. Salen unas tres versiones al año, el proyecto mantiene las tres más recientes y al actualizar no se puede saltar ninguna. Quien opera Kubernetes cambia su plano de control varias veces al año.
Reddit estuvo caído 314 minutos el 14 de marzo de 2023 por una de esas actualizaciones, de la versión 1.23 a la 1.24. La versión nueva quitó una etiqueta de nodo cuyo nombre Kubernetes había cambiado años antes. La red del clúster dependía de esa etiqueta: unos componentes de Calico instalados años atrás, cuya configuración no estaba guardada en ningún repositorio, y todas las personas que sabían de su existencia habían pasado a otros roles o a otras empresas. Kubernetes no tiene un procedimiento soportado para volver a la versión anterior, y Reddit restauró desde un respaldo.
OpenAI dejó sin servicio a ChatGPT, su API y Sora durante 4 horas y 22 minutos el 11 de diciembre de 2024. Había desplegado un servicio de telemetría en sus cientos de clústeres. La configuración hacía que cada nodo ejecutara operaciones costosas contra la API de Kubernetes, y ese costo crecía con el tamaño del clúster. En el clúster de pruebas no se notó. En los grandes saturó los servidores de API y con ellos cayó el DNS, del que los servicios dependen para encontrarse. Para revertir el cambio hacía falta el mismo plano de control que estaba saturado.
Monzo, un banco británico, lo vivió en 2017. Un cambio en etcd hecho en las semanas previas, un bug de Kubernetes y una incompatibilidad de versiones con linkerd, su malla de servicios, dejaron los pagos de cuenta corriente fallando alrededor de una hora y media.

6. Nivel 5: la plataforma interna
Con decenas de clústeres nadie despliega a mano. Las empresas construyen una capa propia que traduce "quiero este servicio" en cambios sobre todos ellos.
Rappi es el caso latinoamericano mejor documentado. Según el caso de estudio que publicó Istio en 2022, operaba más de 50 clústeres de Kubernetes, el mayor con más de 20,000 contenedores, y una API interna sobre ellos para gestionar más de 1,500 despliegues al día. También construyó su propia malla de servicios. Le exigía demasiado mantenimiento y no acompañaba su crecimiento, así que la reemplazó por Istio. Otro caso de proveedor de ese año, el de KrakenD, cifra su equipo de infraestructura en 70 personas.
Uber terminó en julio de 2024 de migrar su plataforma de Mesos a Kubernetes: más de 50 clústeres y 4,000 servicios que se despliegan 100,000 veces al día. Mercado Libre reportó en 2022 más de 26,000 microservicios y 12,000 ingenieros sobre su plataforma Fury.
Skyscanner muestra qué pasa cuando esa capa se equivoca. Entre sus conclusiones hay dos que aplican a cualquier plataforma: no hacer despliegues globales de configuración, y tratar como código, con pruebas, cualquier plantilla que tenga lógica.

7. Lo que tienen en común
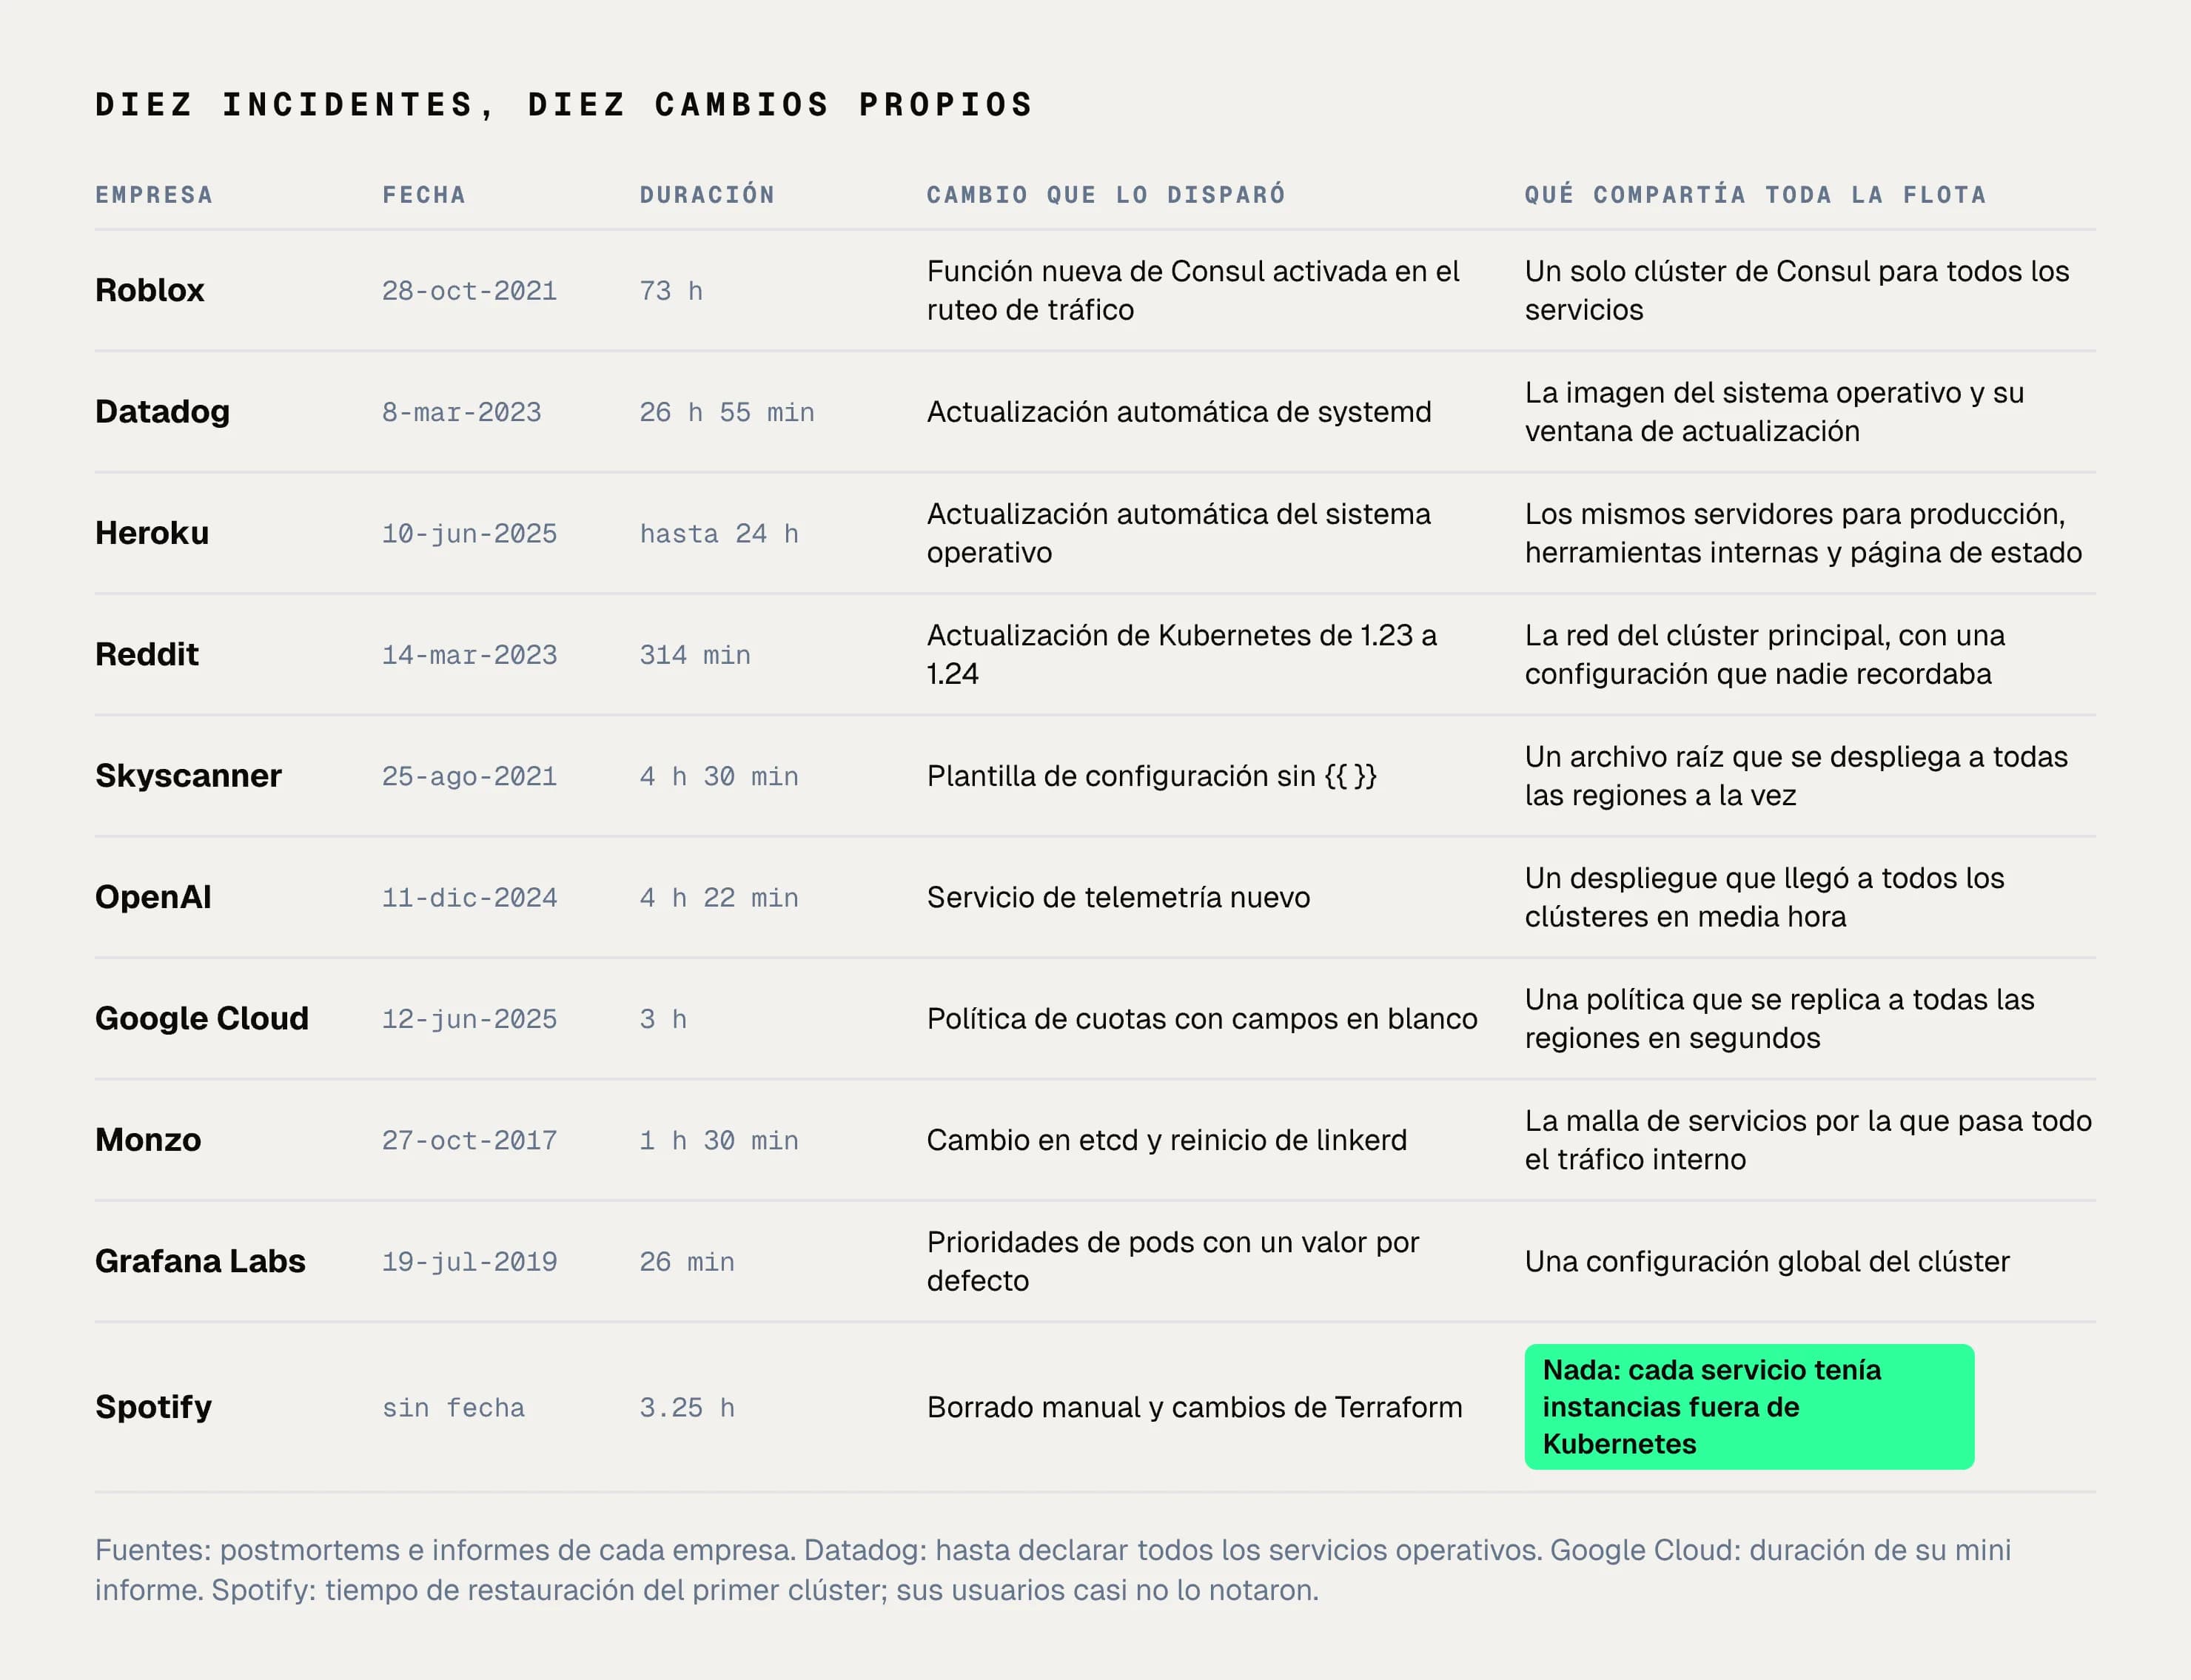
Los diez incidentes que verificamos empezaron con un cambio propio: una actualización de versión, un parche automático, un despliegue interno, una plantilla. Google lo había medido antes en su libro de Site Reliability Engineering: cerca del 70 % de las caídas se deben a cambios en un sistema en producción.
El segundo rasgo es que en cada caso había algo compartido por toda la flota. En Roblox era el clúster de Consul. En Datadog, la imagen del sistema operativo y su ventana de actualización. En Skyscanner, un archivo raíz. En OpenAI, un despliegue que llegó a todos los clústeres en media hora. En Google Cloud, el 12 de junio de 2025, fue una política con campos en blanco que se replicó a todas las regiones en segundos y activó un código que no estaba protegido por una bandera de función.
Heroku estuvo caído hasta 24 horas el 10 de junio de 2025. Una actualización automática del sistema operativo, que debía estar deshabilitada, reinició los servicios de red de sus servidores. Gergely Orosz, en The Pragmatic Engineer, cree que lo más probable es que fuera una actualización de systemd en Ubuntu 22.04, el mismo componente que tumbó a Datadog dos años antes. Heroku no nombra systemd en sus informes.
Datadog resumió su aprendizaje en 2025 con una recomendación: evitar los sistemas de control globales que influyen en muchos servicios, porque suelen convertirse en modos de falla nuevos y complejos.
8. Los que bajaron
37signals probó Kubernetes con soporte de un proveedor sobre hardware propio y lo describió como una idea muy cara y operativamente complicada. Construyó Kamal, una herramienta que despliega contenedores Docker en servidores con comandos directos y sin plano de control. Con ella migró Tadalist en menos de seis semanas, Writeboard en menos de dos y Backpack en unas tres.
Gitpod pasó seis años sobre Kubernetes, con 1.5 millones de usuarios, antes de concluir que no era la opción adecuada para entornos de desarrollo: cargas con mucho estado y con permisos amplios. Construyó Flex, cuyo plano de control describe como muy inspirado en Kubernetes. En el mismo texto aclara que, para cargas de aplicación, Kubernetes sigue siendo una buena opción.
In The Pocket pasó un proyecto de Kubernetes en AWS a ECS con Fargate. Su equipo se había cansado de terminar a mano las instancias EC2 en cada mantenimiento de AWS y de mantener los charts de Helm.
Los tres siguen corriendo contenedores. Lo que quitaron fue la capa de gestión que les costaba operar.
9. Cómo se sobrevive
La primera defensa es partir la flota. Figma corre cada servicio en tres clústeres de Kubernetes activos. Cuando un operador destruyó y recreó por accidente el DNS interno de uno de ellos, el impacto se limitó a un tercio de las solicitudes. AWS llama a esto cell-based architecture y lo recomienda en su Well-Architected Framework: con diez celdas, la falla de una deja intacto el 90 % de las solicitudes. Figma reconoce el costo: es bastante más complejo de construir y de operar.
Spotify borró por error clústeres de producción en dos incidentes separados por un mes. Kubernetes estaba en beta dentro de la empresa y los equipos habían migrado solo una parte de las instancias de cada servicio. El descubrimiento de servicios dejó de listar los contenedores borrados y los clientes recibieron las instancias que seguían fuera de Kubernetes. Restaurar el primer clúster tomó 3.25 horas.
La segunda defensa es que ningún cambio llegue a todo a la vez. Una de las lecciones que Google SRE publicó tras veinte años de incidentes es probar todo cambio primero en una porción pequeña, lo que en la industria se llama canary. AWS cataloga como antipatrón desplegar a todas las celdas al mismo tiempo.
La tercera es seguir sirviendo a medias, o graceful degradation. Datadog rediseñó sus productos para degradarse por partes en lugar de caer completos, y reporta un 30 % menos de incidentes significativos en los monitores de sus clientes. OpenAI se propuso desacoplar el plano de datos del plano de control, para que este último deje de ser imprescindible al atender solicitudes.

10. Cómo elegir tu nivel
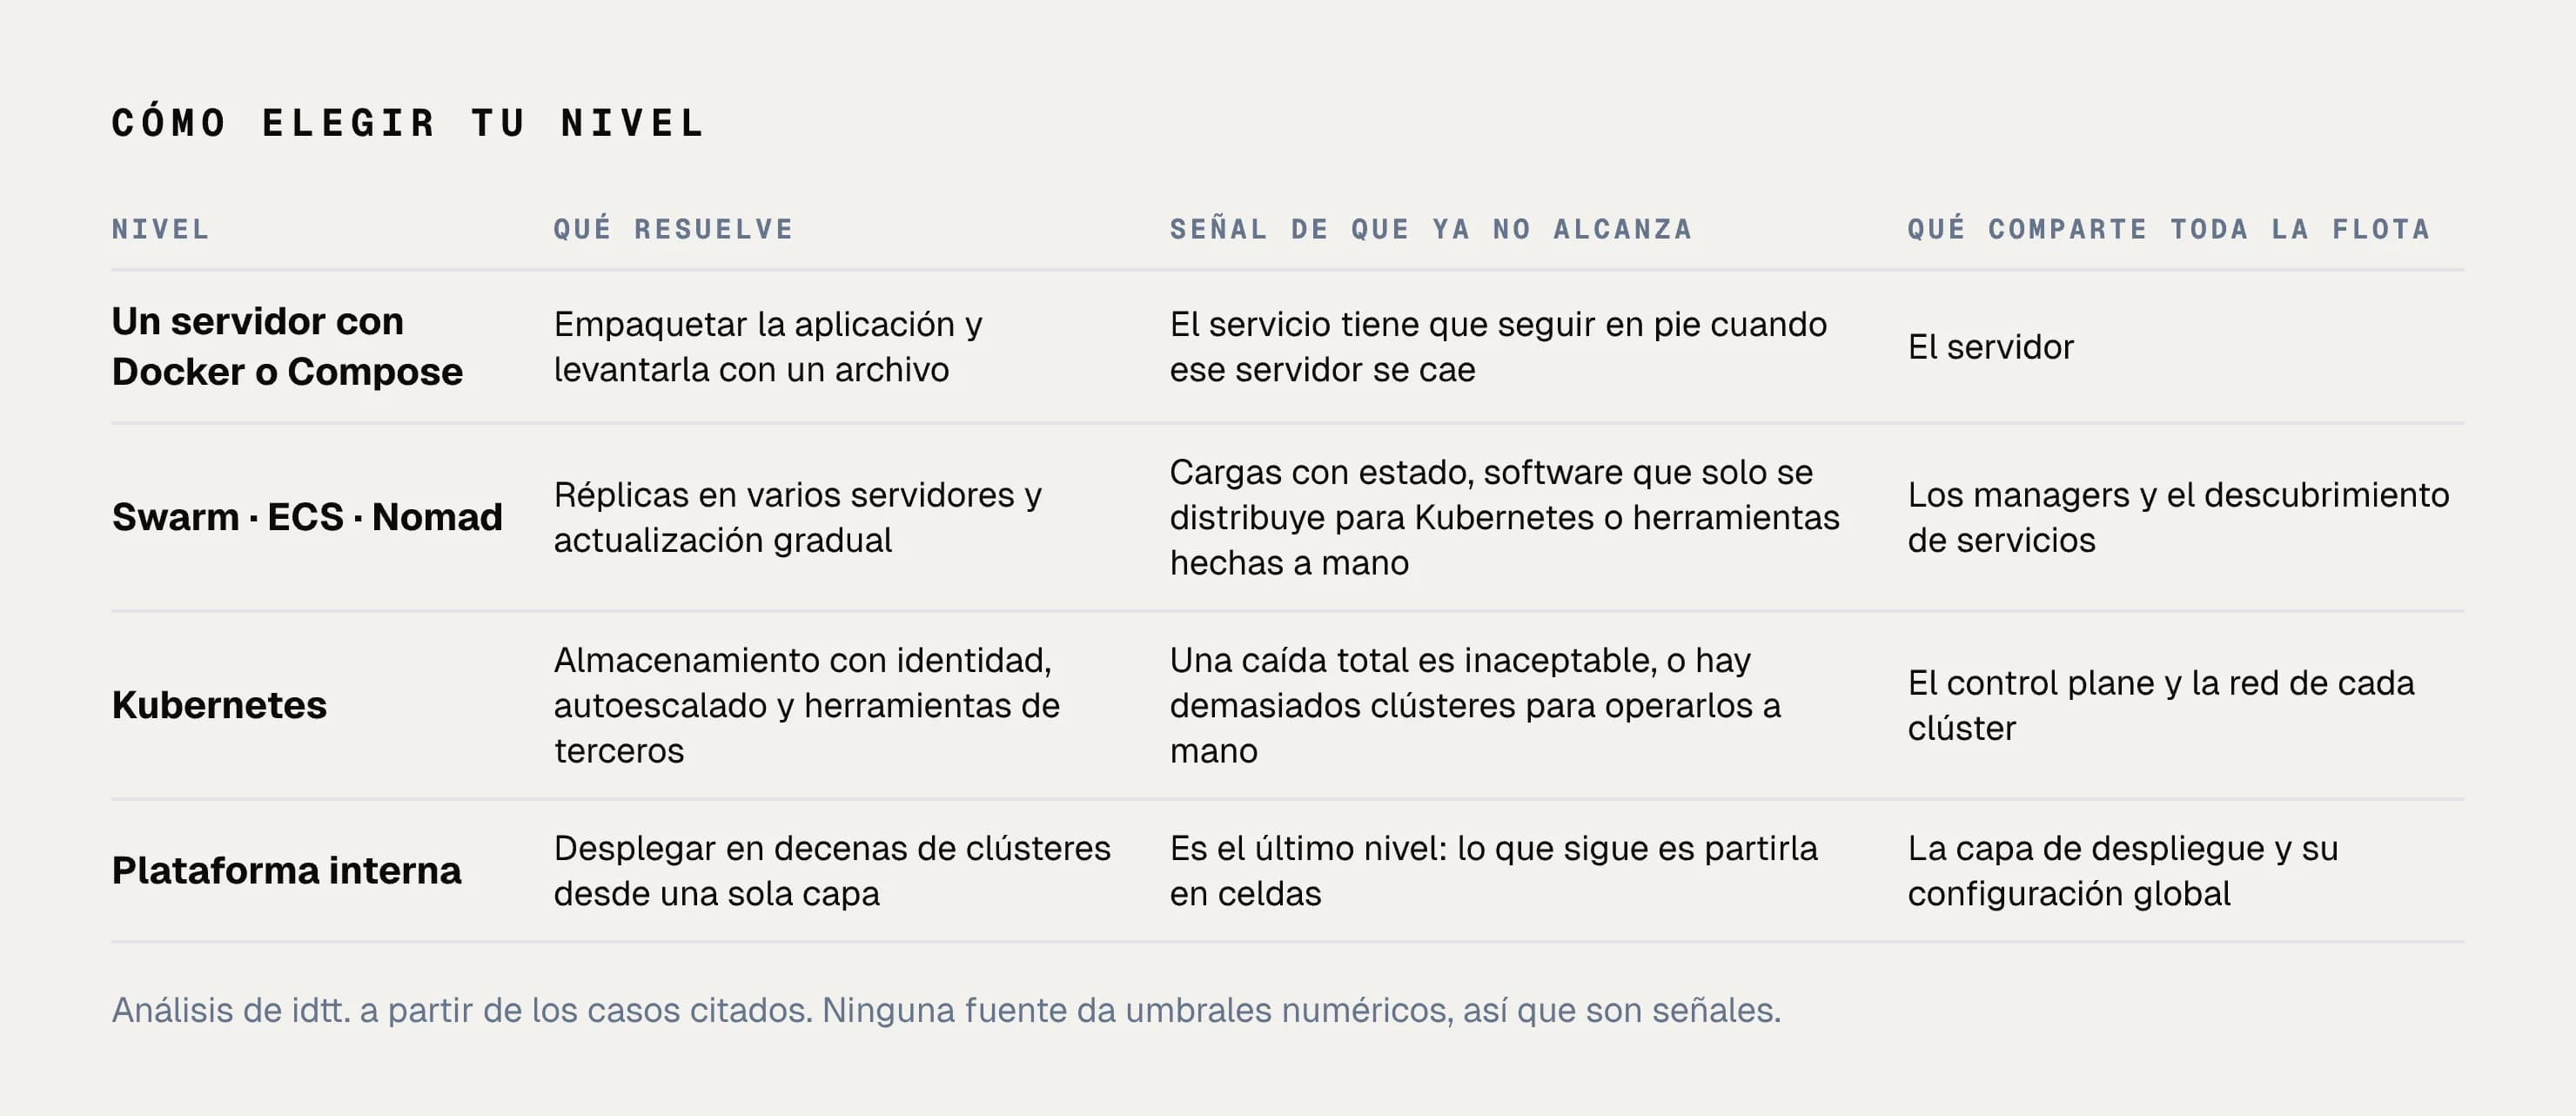
Lo que sigue es análisis nuestro a partir de los casos. Ninguna de las fuentes da umbrales numéricos, así que hablamos de señales.
Un servidor con Docker Compose alcanza mientras el negocio tolere que esa máquina se caiga. La señal para subir es necesitar que el servicio siga en pie cuando un servidor falla.
Swarm, ECS o Nomad alcanzan mientras las cargas sean servicios sin estado y no se dependa de software que solo se distribuye para Kubernetes. Las señales para subir son las de Figma, o descubrir, como OneLogin, que el equipo está construyendo a mano lo que la herramienta no trae.
Kubernetes pide presupuestar su mantenimiento: varias actualizaciones del plano de control al año, una versión a la vez. Cuando una caída total sea inaceptable, pide además más de un clúster.
La plataforma interna aparece cuando hay decenas de clústeres. Rappi, el caso que lo documenta, tenía un equipo de infraestructura de 70 personas.
Antes de subir de nivel conviene responder cuatro preguntas. Qué comparte toda la flota. Si un cambio puede llegar a todo al mismo tiempo. Si existe un camino de vuelta y se ha probado, porque Reddit descubrió en plena caída que su restauración estaba llena de trampas. Y si el monitoreo depende del mismo sistema que vigila, que fue lo que dejó a Roblox sin datos para diagnosticar.
El nivel adecuado es el más bajo que resuelve el problema que el equipo tiene hoy, con su volumetría y su complejidad. Después de 73 horas caída, Roblox siguió con Nomad y Consul. Lo que cambió fue repartir los servicios críticos en clústeres dedicados y separar la telemetría.
Más notas del equipo
/ QUIERO ALGO SIMILAR
Tu próximo proyectoempieza hoy.
Cuéntanos qué necesitas y te decimos cómo lo resolveríamos.
Hablemos
O escríbenos directo → hola@identity.pe