
Loki vs Tempo: logs y trazas, medidos
Instrumentamos una billetera digital con OpenTelemetry y le provocamos tres incidentes. Loki encontró cada error y cada cliente; Tempo fue el único que mostró dónde se iba el tiempo de un pago lento. También medimos cuánto cuesta cada uno y qué se pierde al muestrear.
Un cliente escribe al soporte: su pago tardó una eternidad. Otro dice que le salió un error. El equipo abre los logs y encuentra miles de líneas por segundo. ¿Cuál de ellas explica lo que pasó? En una arquitectura de microservicios, un solo pago cruza varios servicios y una base de datos antes de responder, y cada pieza deja su propio rastro.
Grafana ofrece dos herramientas para ese rastro: Loki, para los logs, y Tempo, para las trazas. En Google la búsqueda "Loki vs Tempo" aparece como si hubiera que elegir entre las dos. Quisimos responderla con datos. Instrumentamos la billetera digital de nuestro estudio de CQRS, le provocamos tres incidentes y medimos qué encuentra cada una, cómo se conectan y cuánto cuesta cada una por request. El laboratorio es público: github.com/idtt-pe/loki-tempo-lab.
1. El problema: un pago lento y nadie sabe dónde
Google describió el problema en 2010, en el paper de Dapper, su sistema de trazas: un ingeniero que solo mira la latencia total puede saber que hay un problema, pero no adivinar qué servicio tiene la culpa ni por qué. Uber lo contó en 2017, cuando pasó de unos 500 microservicios a más de 2,000: las métricas y los logs siguen siendo útiles, pero muchas veces no dan visibilidad entre servicios.
Los logs cuentan lo que cada servicio decidió registrar. Una traza cuenta el recorrido completo de un request: qué servicios tocó, en qué orden y cuánto tardó en cada uno. Cada tramo de ese recorrido se llama span.

2. Qué es Grafana Loki
Loki es una base de datos para logs. Su diferencia con otras está en lo que indexa: solo las etiquetas de cada flujo de logs (el servicio, el nivel, el entorno) y nunca el texto de la línea. El contenido se guarda comprimido en bloques llamados chunks, en disco o en almacenamiento de objetos como S3. Por eso su índice es pequeño y su almacenamiento barato.
Se consulta con LogQL. Primero se eligen los flujos por etiquetas, {service_name="command-api", level="error"}, y después se filtra el texto: |= "antifraud" o | json | duration_ms > 1000. El filtro de texto obliga a Loki a leer los chunks del rango de tiempo, porque ese contenido no está indexado.
Desde Loki 3.0 existe la structured metadata: datos que viajan con cada línea sin ser etiquetas ni formar parte del texto, como el trace_id. Y un cambio práctico: Promtail, el agente que muchos tutoriales todavía usan para enviar logs, llegó a su fin de vida el 2 de marzo de 2026. Su reemplazo es Grafana Alloy, que es lo que usamos.
3. Qué es Grafana Tempo
Tempo es una base de datos para trazas. Nació en Grafana Labs en 2020 porque sus ingenieros querían guardar el 100 % de las trazas sin mantener un clúster de Elasticsearch o Cassandra. Su idea fue no indexar las trazas: llegar a ellas por el trace_id que aparece en los logs. En ese momento procesaba 170,000 spans por segundo en su propia infraestructura.
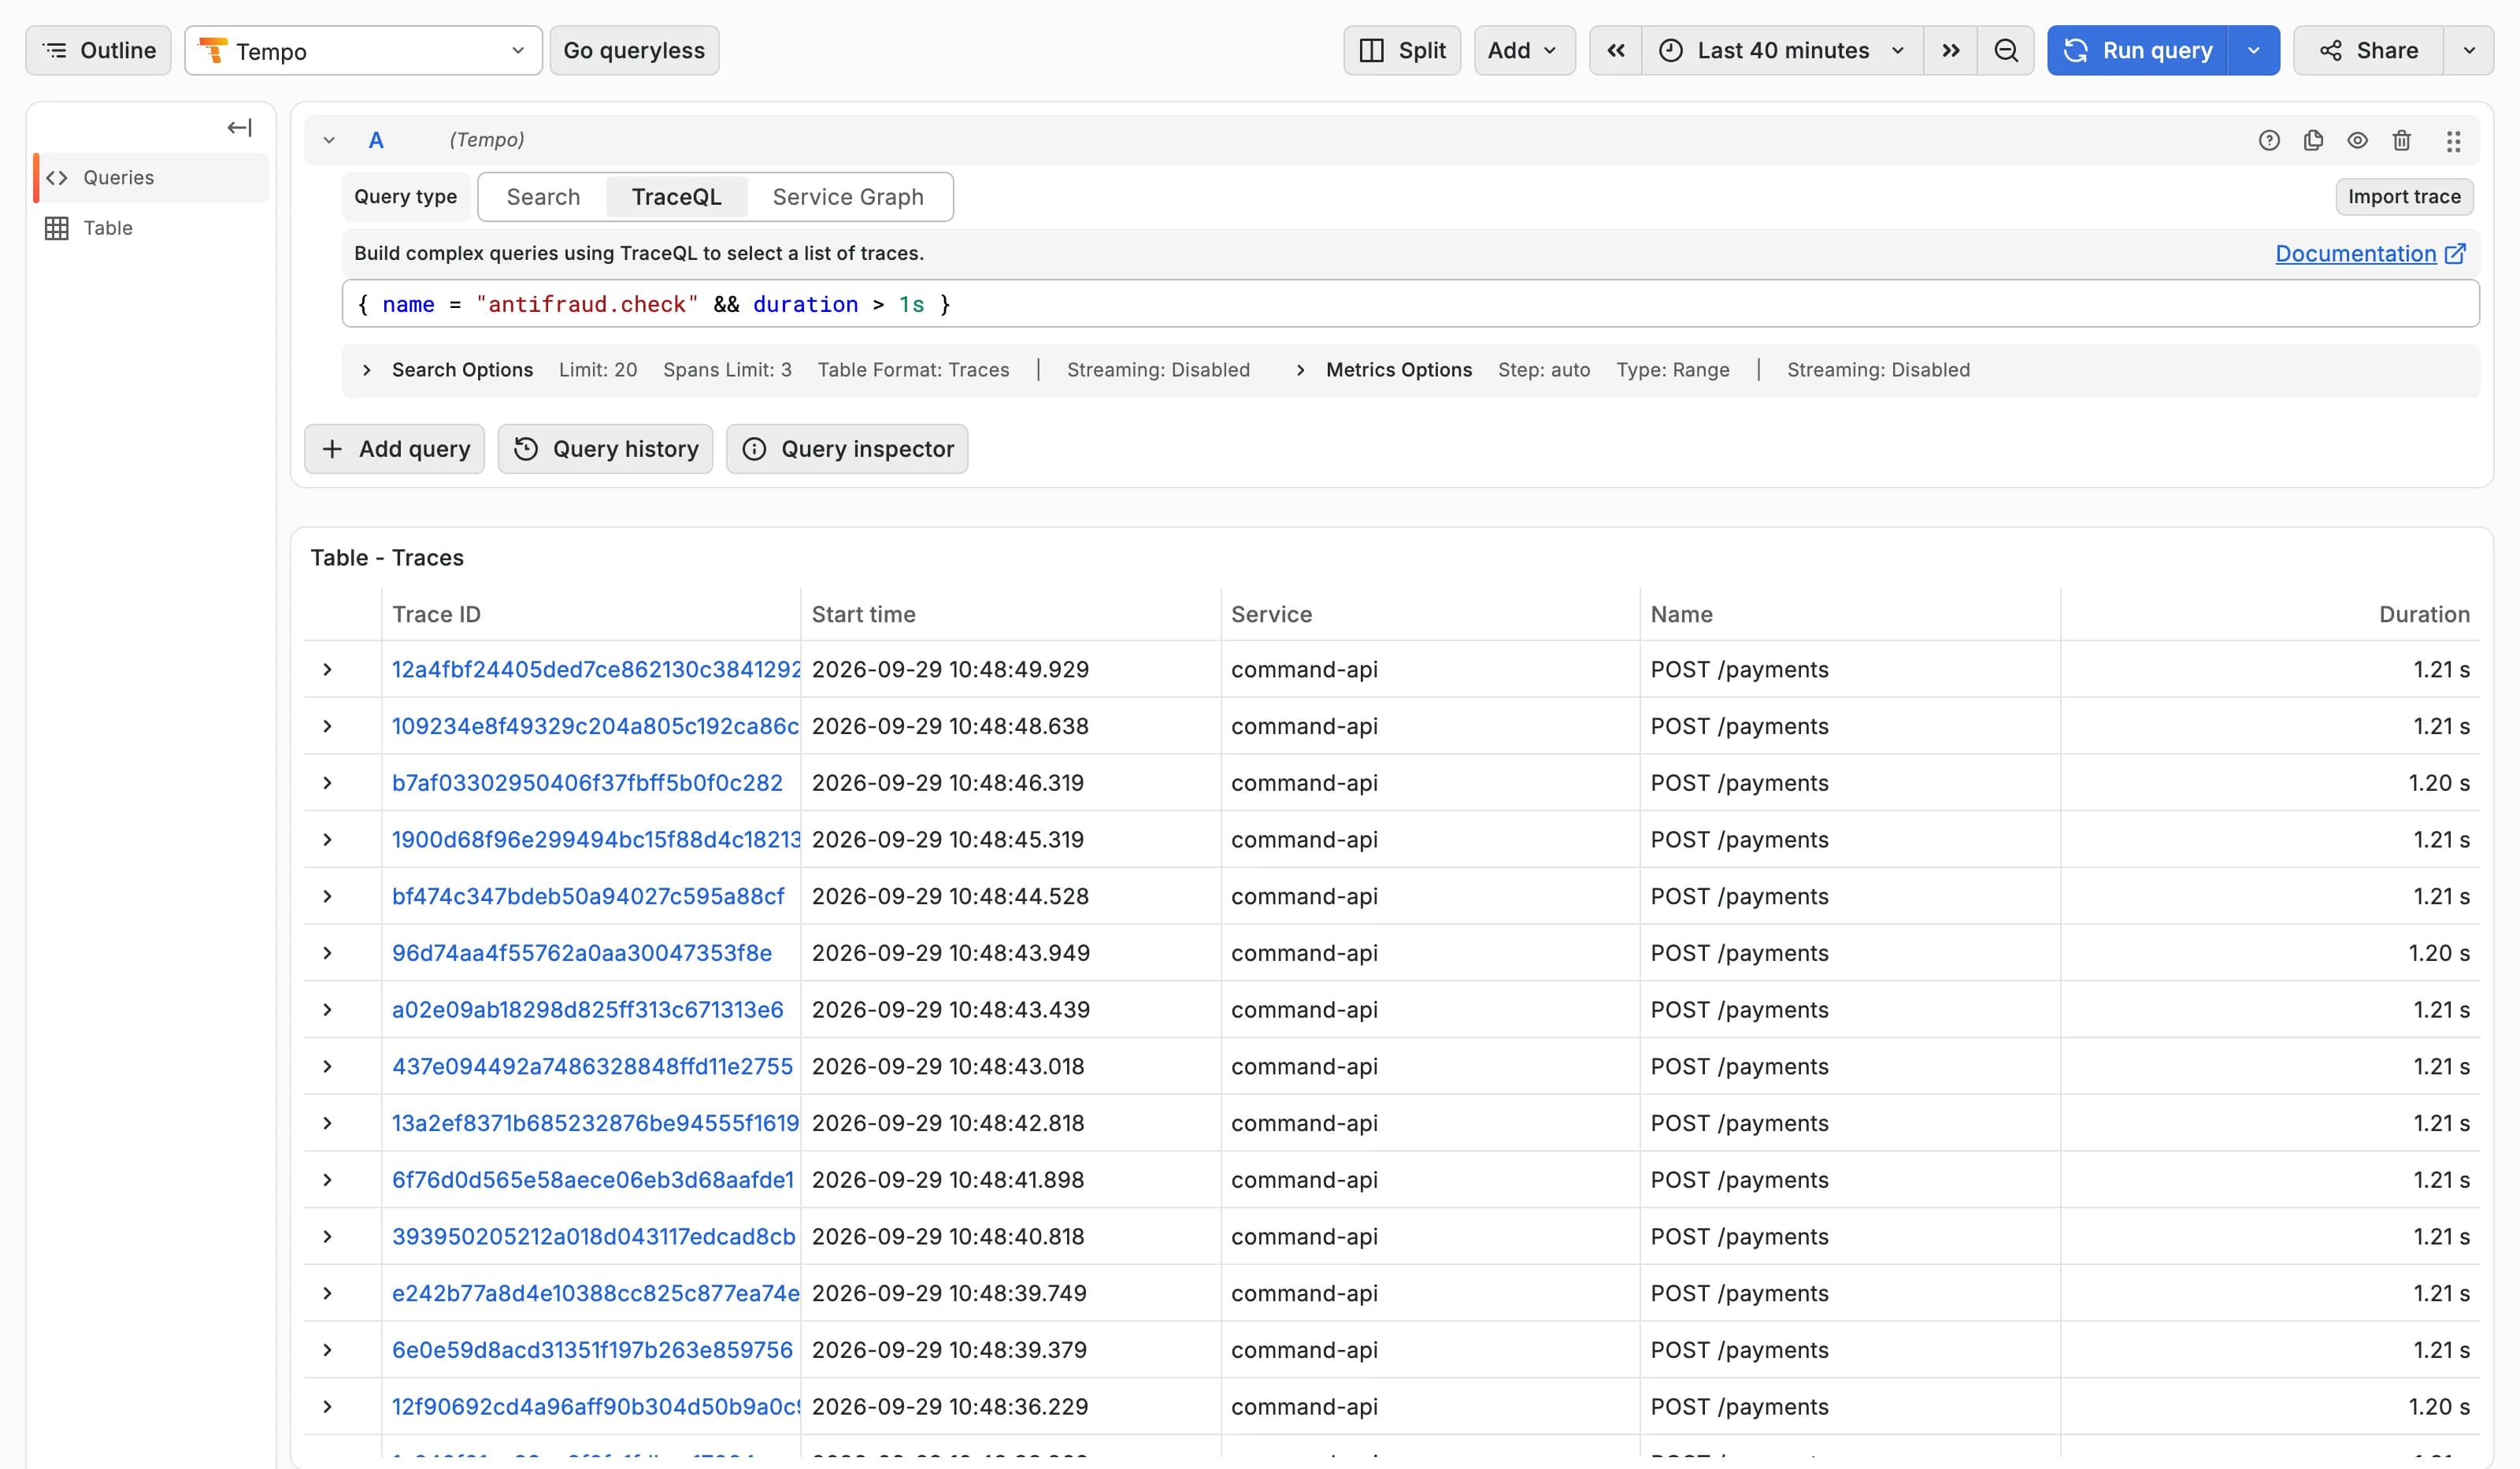
Hoy guarda las trazas en formato Parquet, columnar, y se consulta con TraceQL: { status = error } devuelve las trazas con errores y { name = "antifraud.check" && duration > 1s } las que se demoraron en ese paso. Tempo 3.0 salió el 28 de mayo de 2026 con una arquitectura nueva que separa escritura y lectura: en producción usa Kafka como buffer, y en modo de un solo proceso, el que usamos, no lo necesita. Con esa versión, las métricas calculadas desde trazas (TraceQL metrics) quedaron como estables.
4. El laboratorio
Tomamos la billetera del estudio de CQRS: una API de pagos, una API de consultas, dos bases Postgres, un outbox, Kafka (con Redpanda) y un proyector que arma el modelo de lectura. Le agregamos un servicio antifraude que simula a un proveedor externo: responde a cada pago, pero no nos da sus logs ni sus trazas, como pasa con un tercero real.
Cada servicio escribe un log JSON por request con su trace_id, y OpenTelemetry genera los spans. La traza sigue al pago incluso a través de Kafka: el contexto viaja en el outbox y en los headers del mensaje, así que el mismo trace_id une el pago con su proyección en la base de lectura. Grafana Alloy recoge los logs y las trazas y los envía a Loki 3.7 y a Tempo 3.0.

La carga dura 8 minutos: 100 pagos, 10 recargas, 200 estados de cuenta y 20 tableros de comercio por segundo, unos 158,000 requests por corrida. En los minutos 2 a 4, el antifraude falla en el 3 % de los pagos. En los minutos 4 a 6, los pagos de S/ 45 o más tardan 1.2 segundos más, sin ningún error. Un cliente frecuente, la billetera 777, hace el 0.5 % del tráfico. Repetimos la corrida cuatro veces: con el 100 % de las trazas, con head sampling, con tail sampling y con el trace_id como etiqueta de Loki.
5. Caso 1: el pago falla
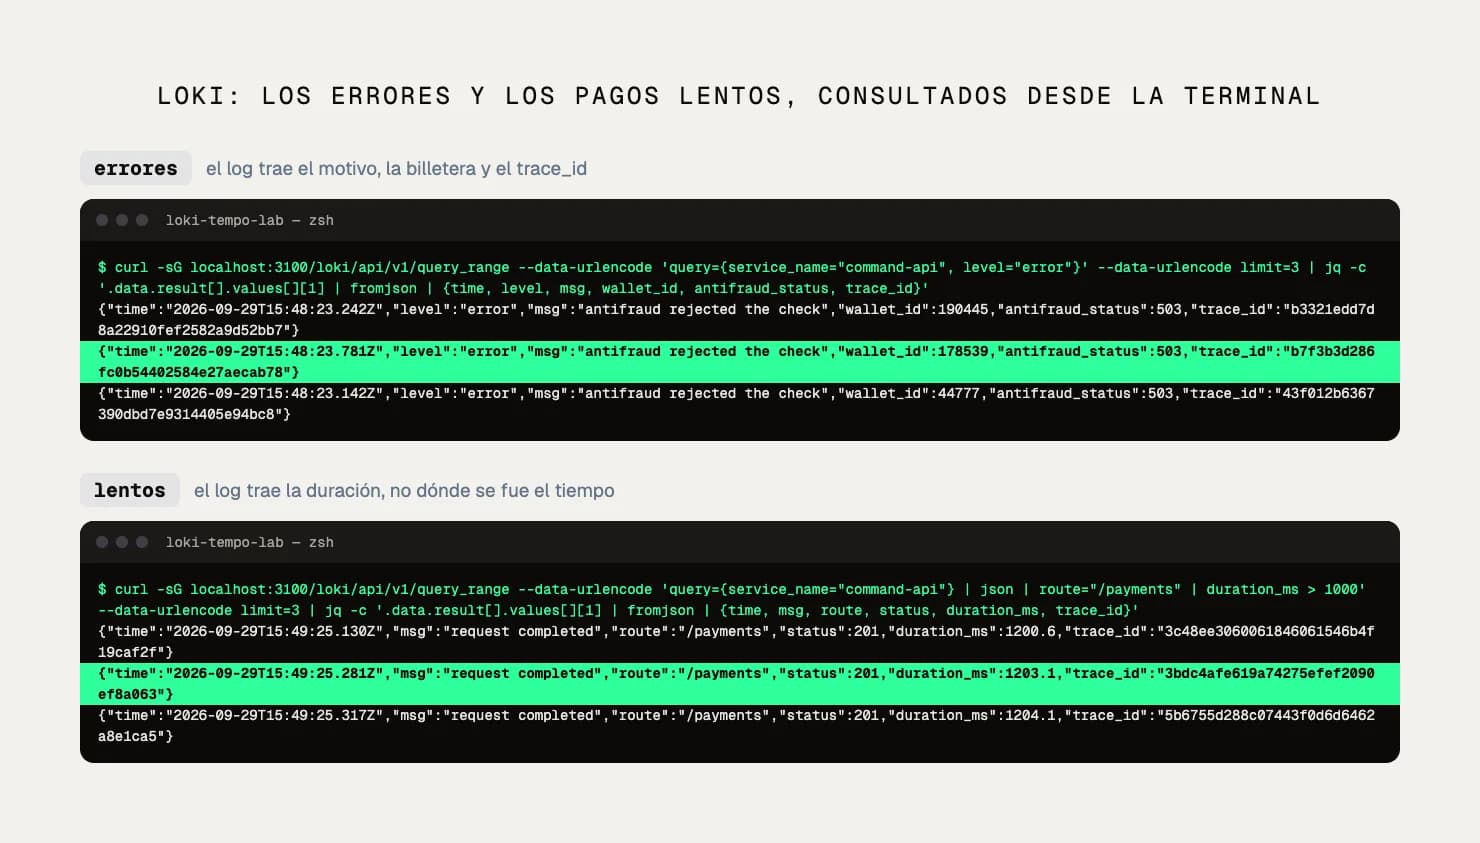
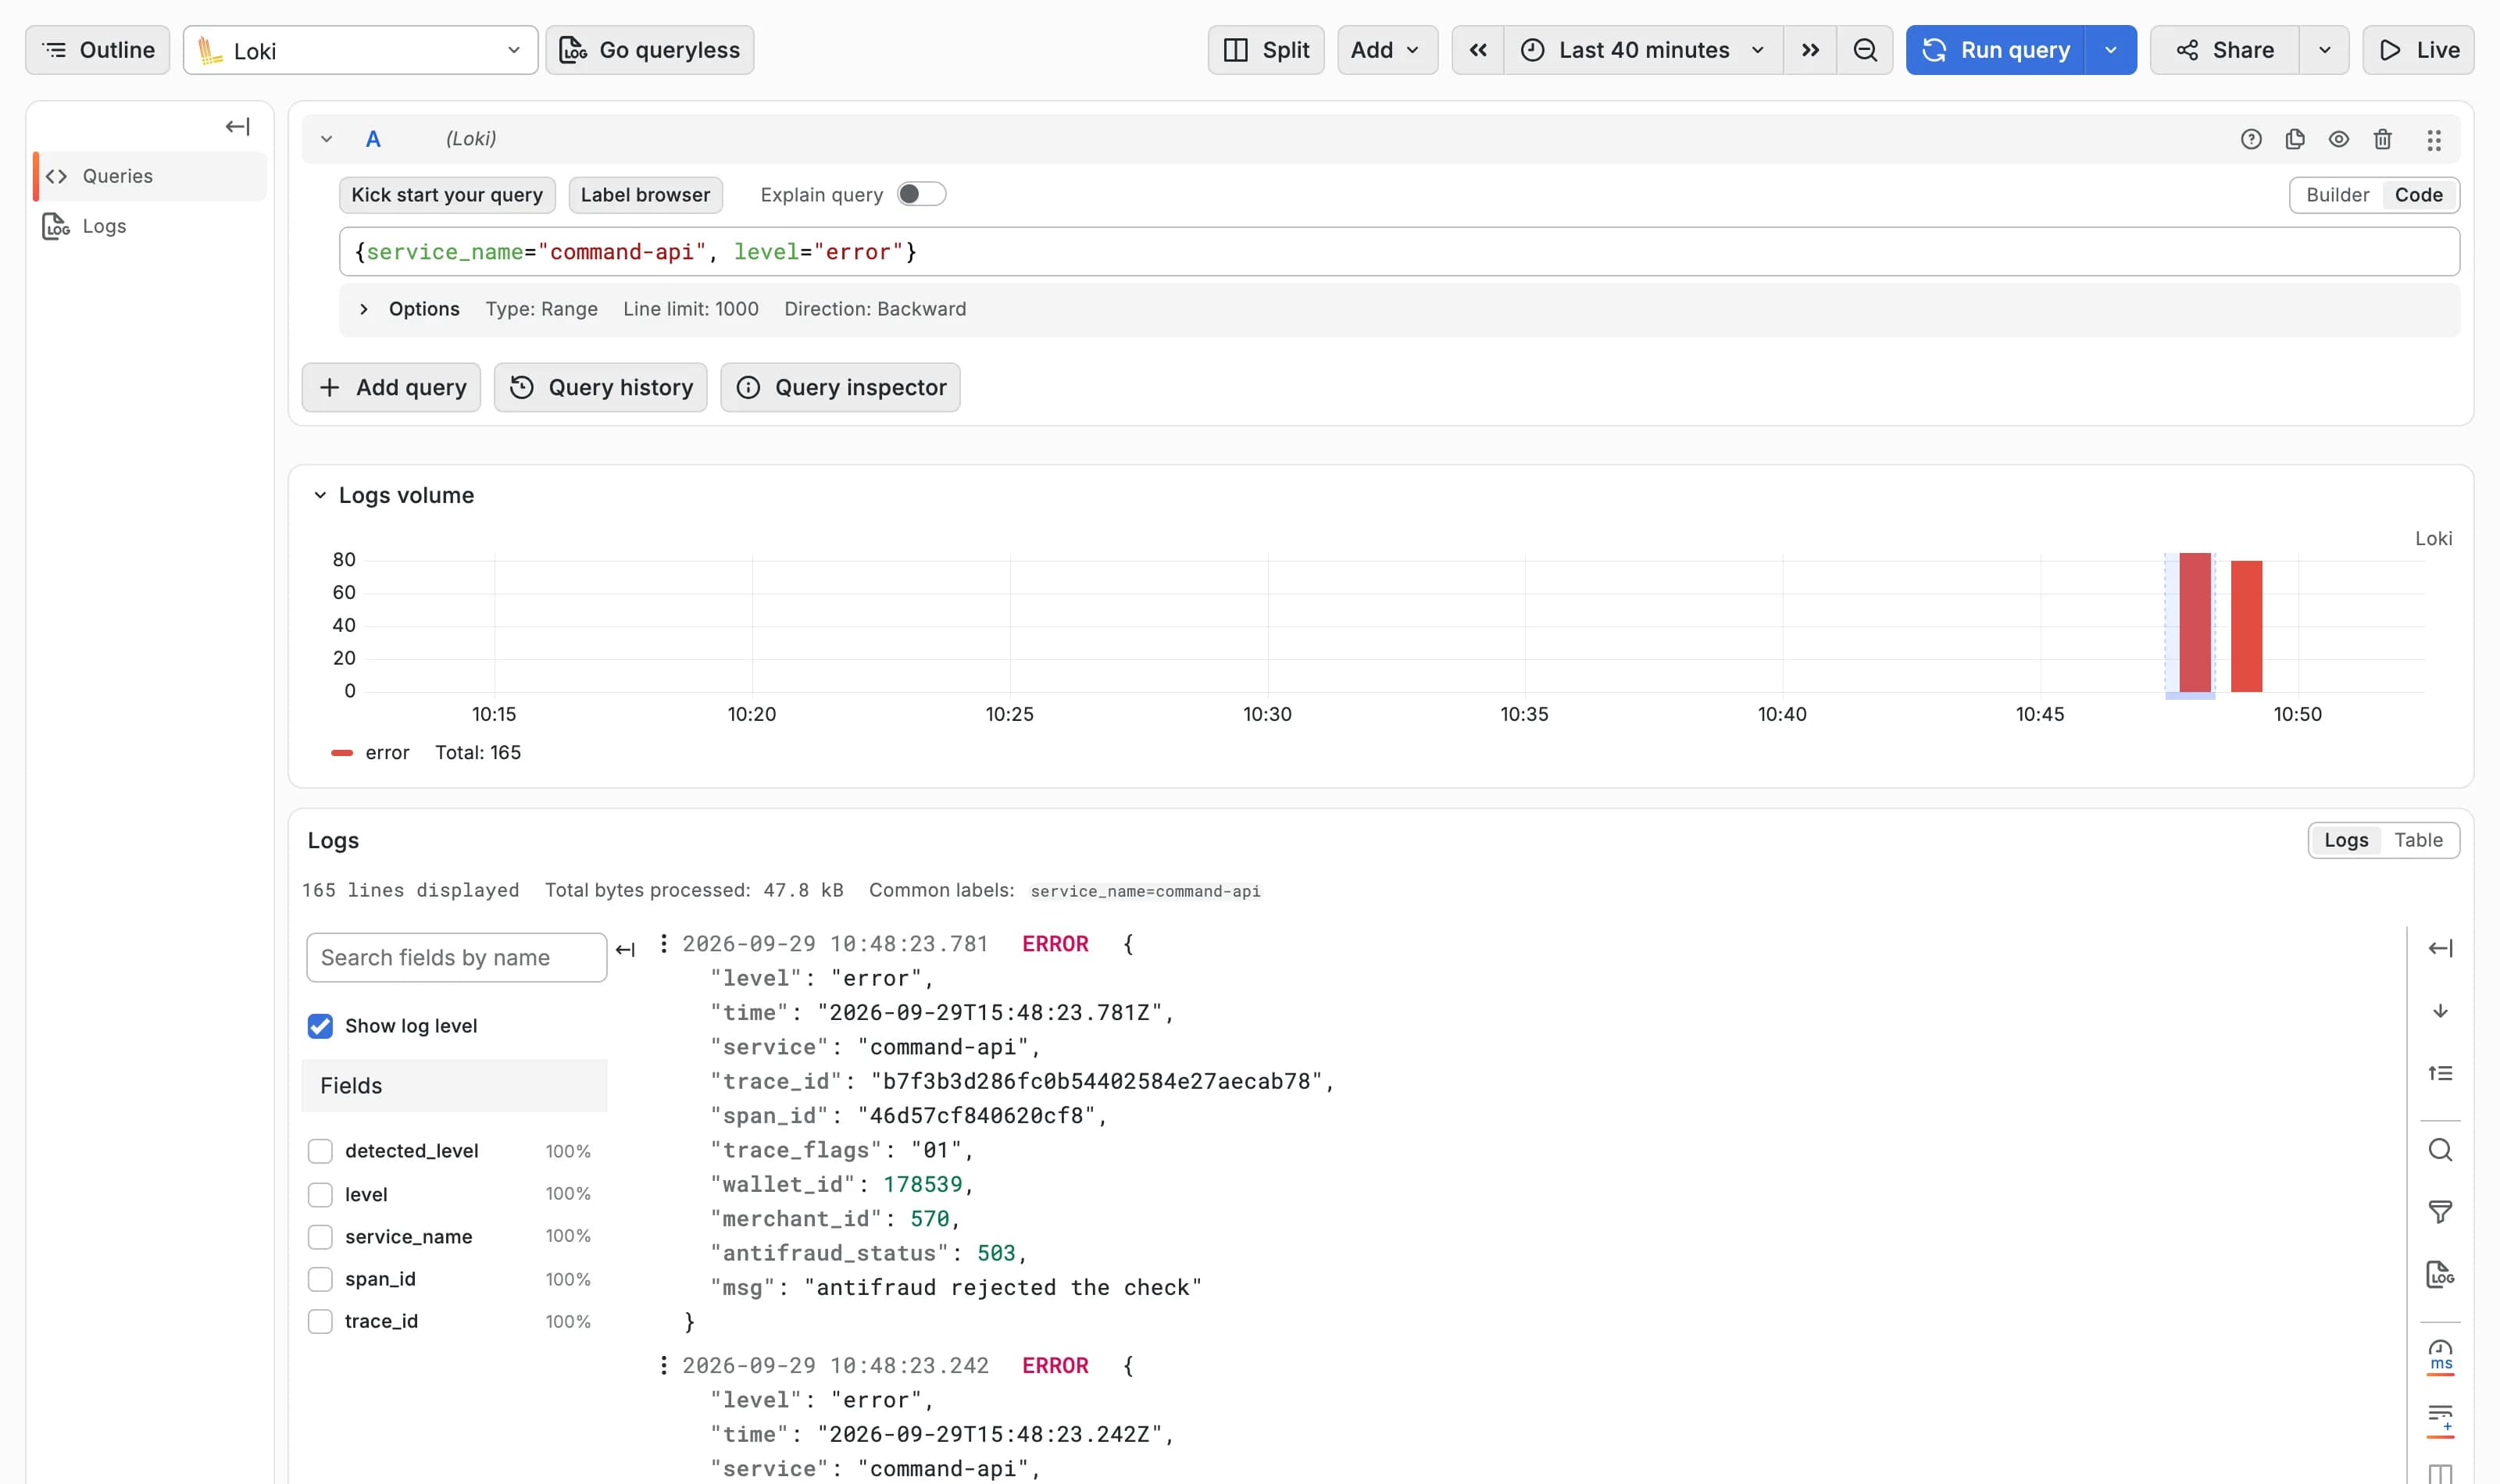
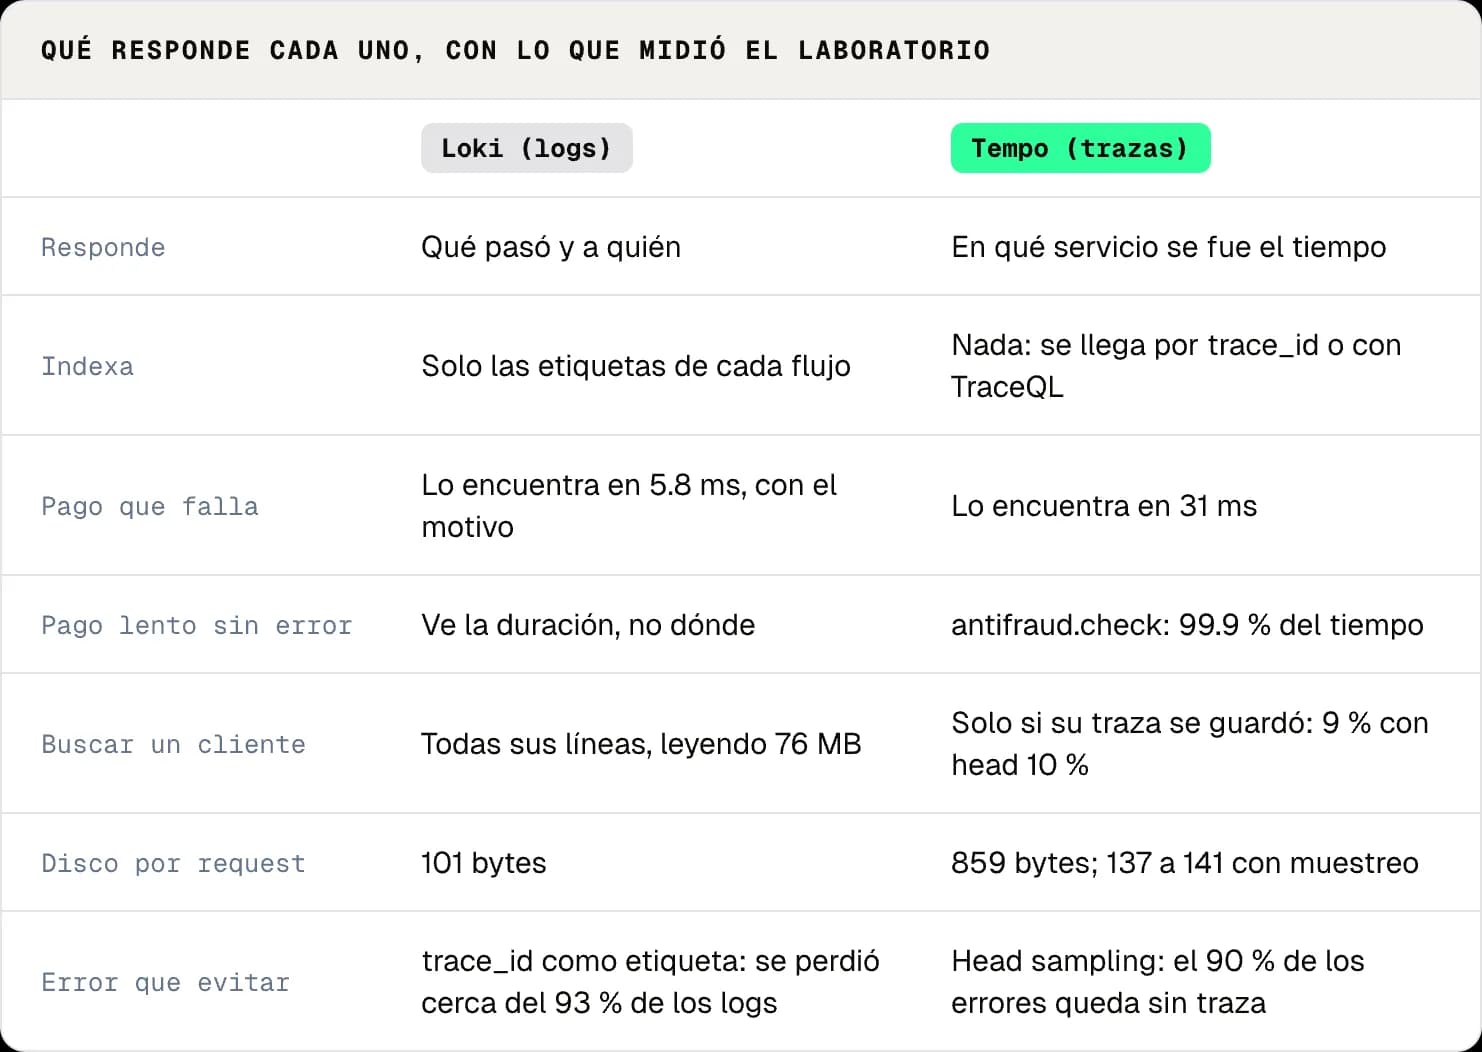
En la ventana de errores fallaron 331 pagos. Los dos lo encontraron. En Loki bastó elegir el flujo por etiquetas, {service_name="command-api", level="error"}: la consulta tardó 5.8 ms y leyó 0.1 MB, porque el nivel es una etiqueta indexada. Como el motivo quedó escrito en el código, la línea ya explica el fallo: "antifraud rejected the check", con el código 503 y la billetera. En Tempo, { status = error } tardó 31 ms y marcó con error el span del antifraude.
6. Caso 2: el pago es lento y no hay errores
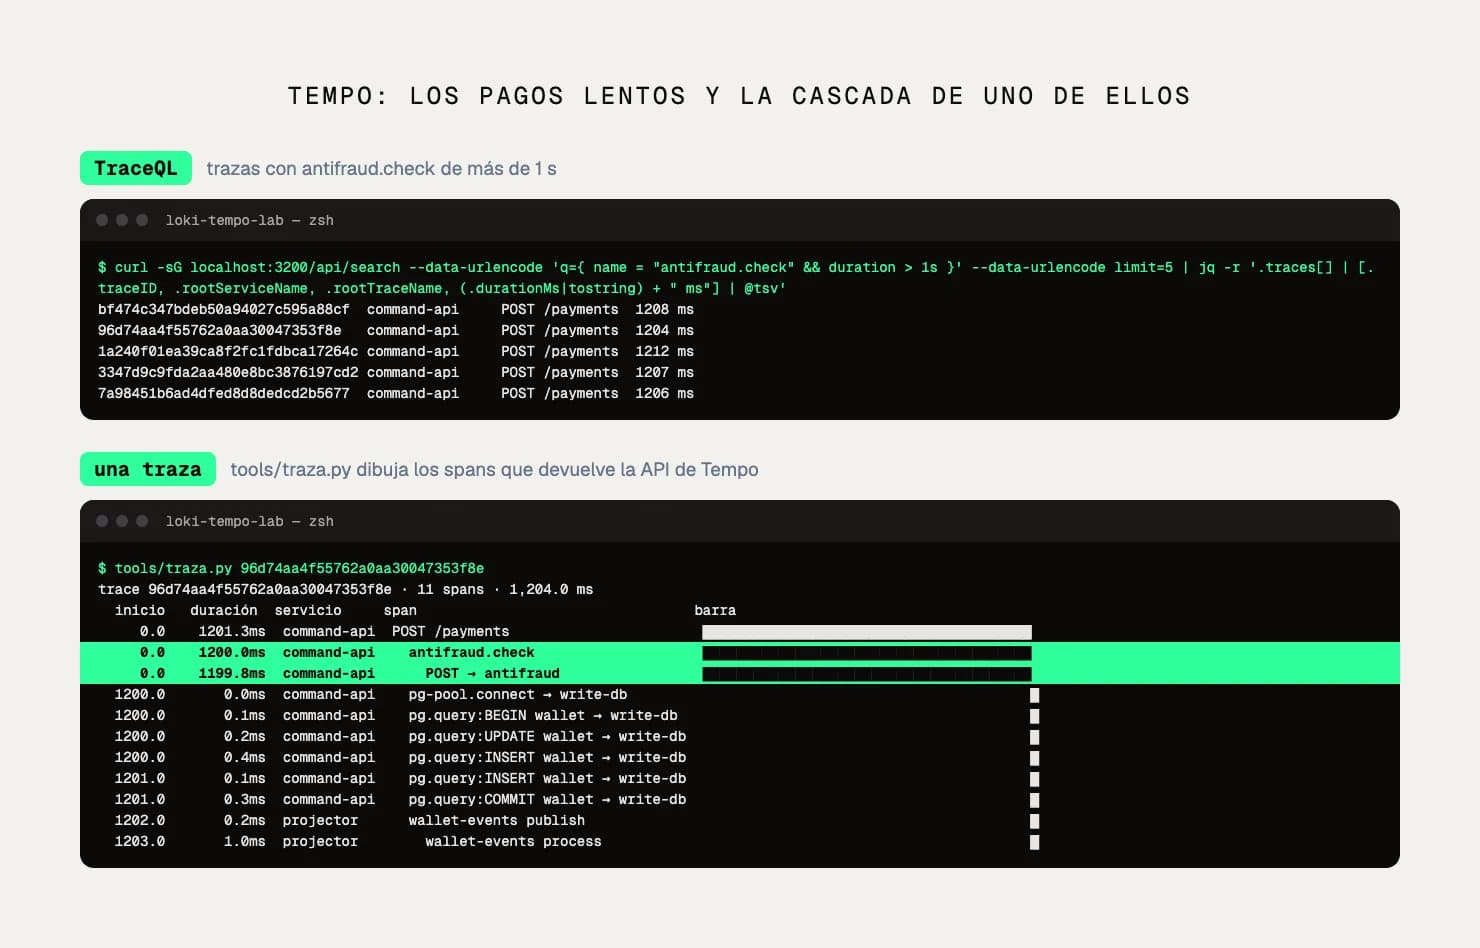
En la ventana lenta, 1,330 pagos tardaron más de un segundo y ningún servicio registró un error. Como nuestro log de acceso guarda la duración, Loki los encontró con | json | route="/payments" | duration_ms > 1000, en 111 ms y leyendo 10.1 MB. Cada línea dice "request completed" con unos 1,203 ms de duración, sin indicar si el tiempo se fue en la base, en Kafka o en el antifraude.
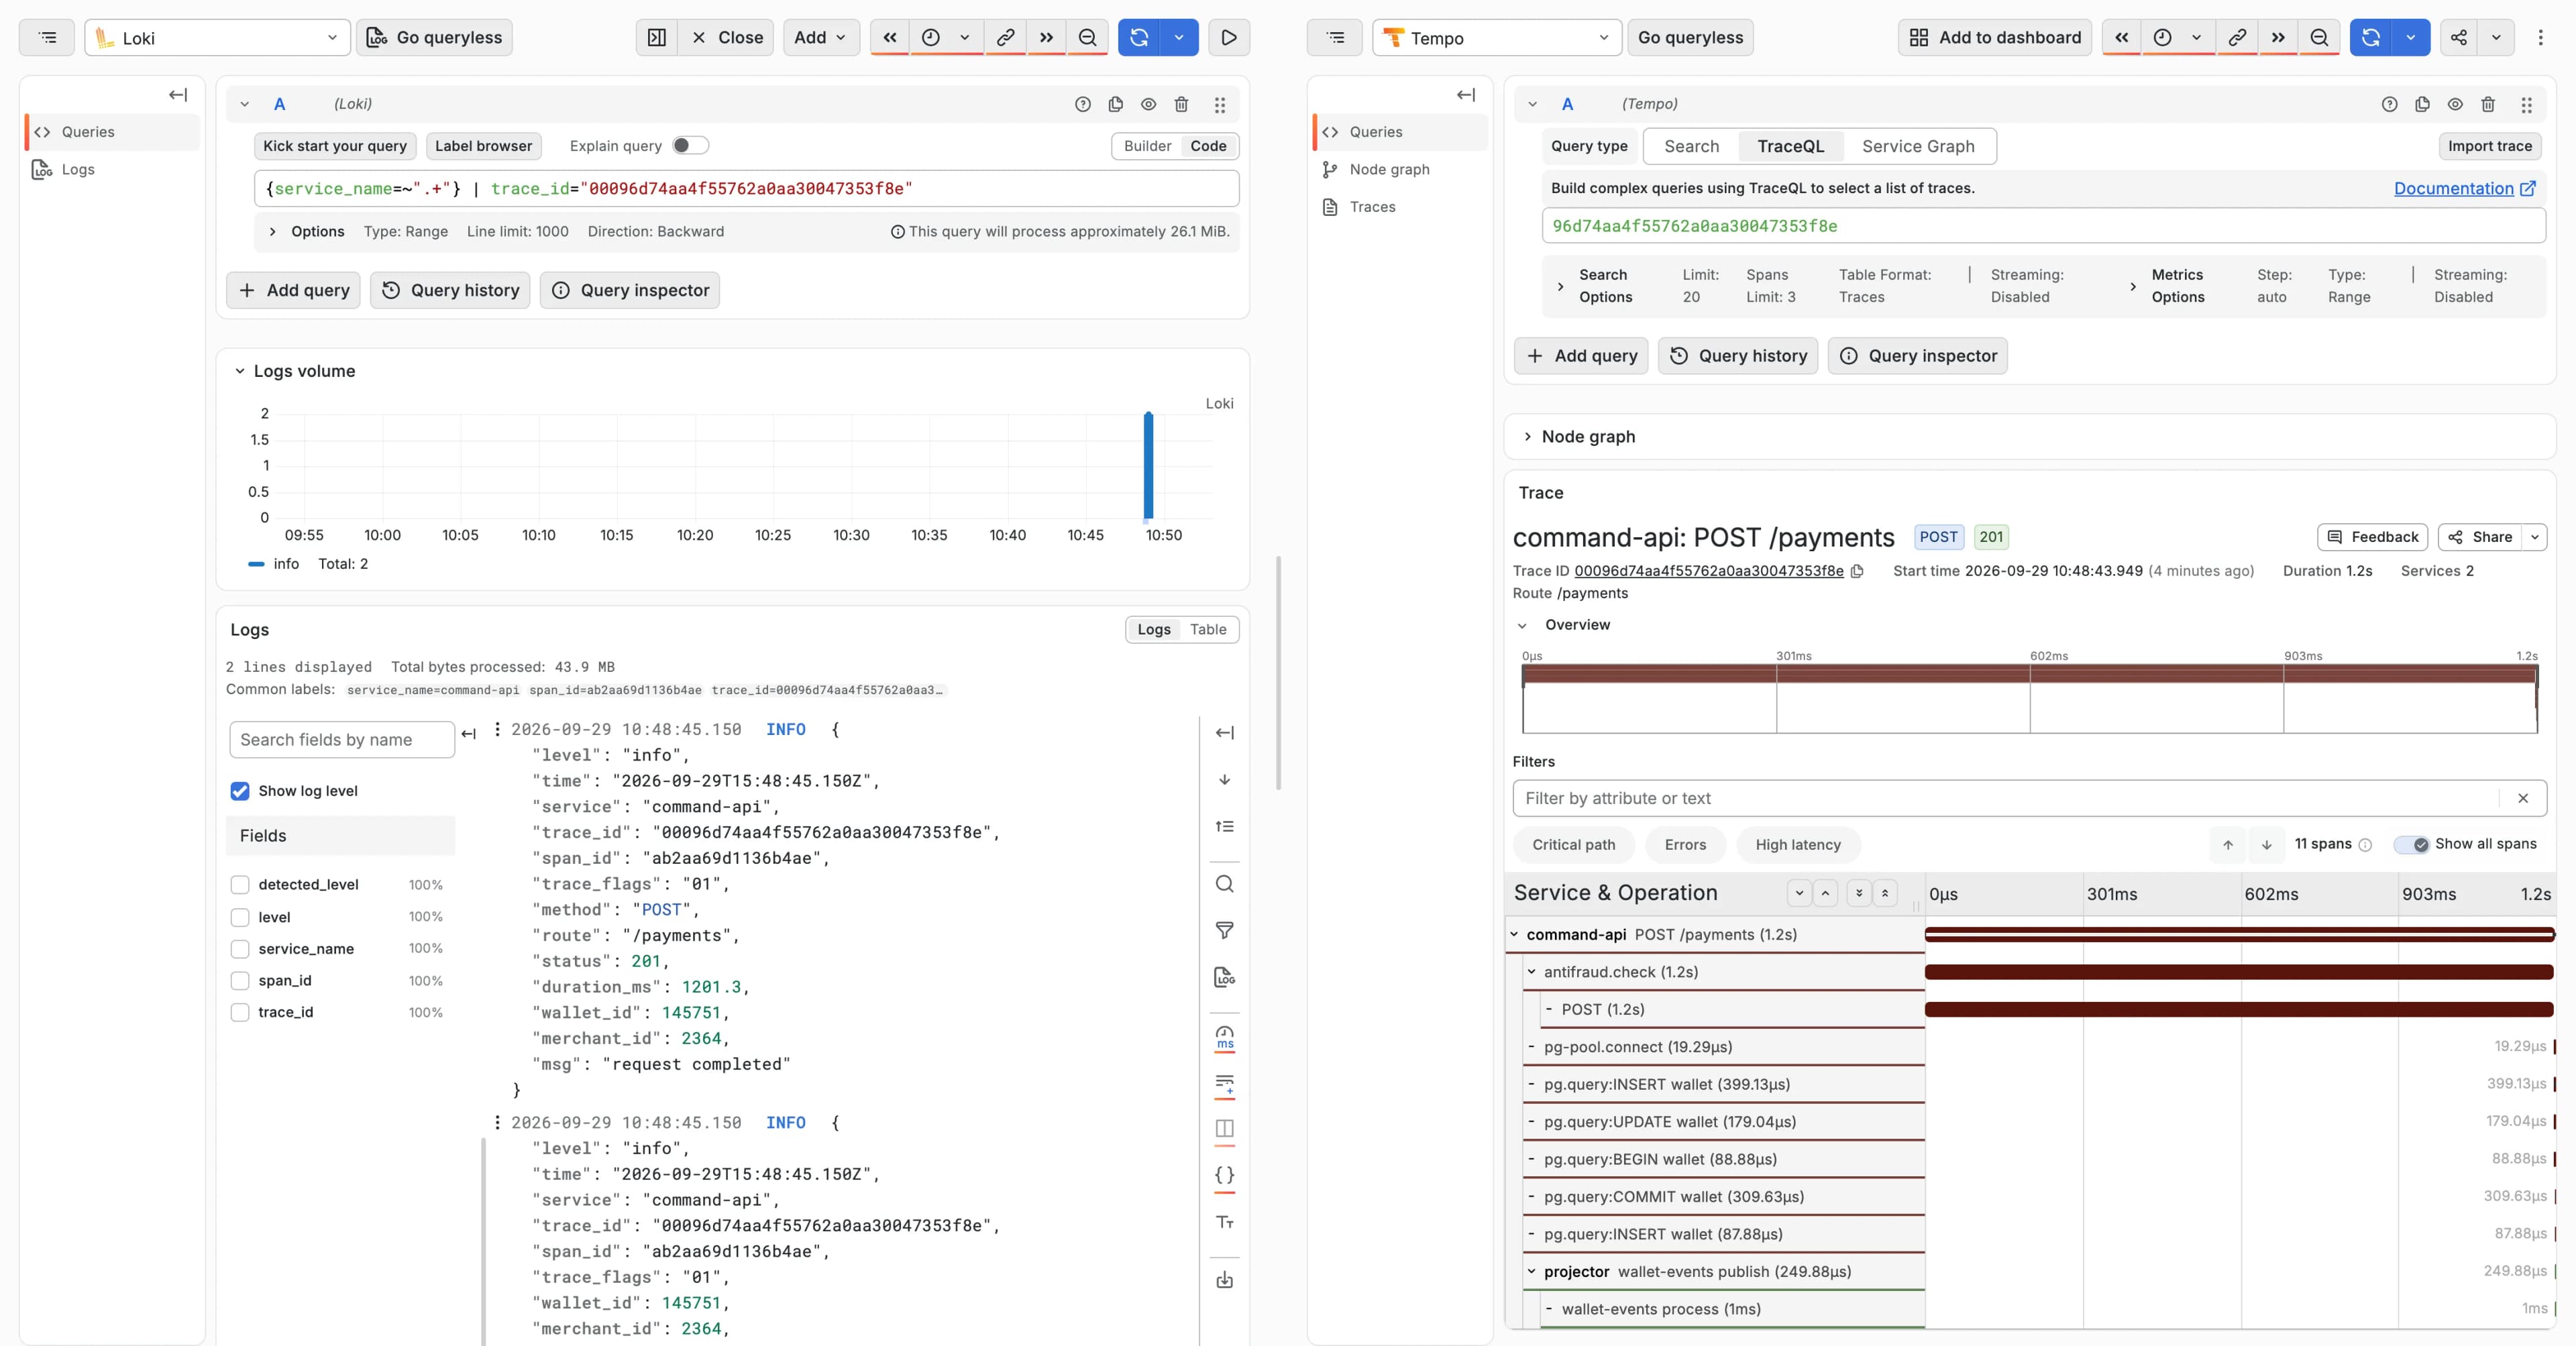
Para eso sirve la traza. Revisamos 100 trazas lentas en Tempo: en la mediana, el span antifraud.check ocupó 1,201 de los 1,203 ms del pago, el 99.9 %, y las consultas SQL sumaron 1.1 ms. Como el antifraude es un tercero sin logs, esa traza es la única evidencia de su demora que queda de nuestro lado. La consulta { name = "antifraud.check" && duration > 1s } tardó 17 ms.

7. Caso 3: ¿qué le pasó a este cliente?
El cliente de la billetera 777 hizo 741 requests en 8 minutos. En Loki, |= "\"wallet_id\":777," los encontró en 227 ms, pero tuvo que leer 76 MB: todos los logs de los dos servicios en la ventana. Así funciona Loki cuando se busca un valor que no es etiqueta. Grafana Labs midió lo mismo a su escala: en siete días sus clústeres procesaron 280 PB de logs y cerca de 140 PB no coincidieron con ningún filtro.
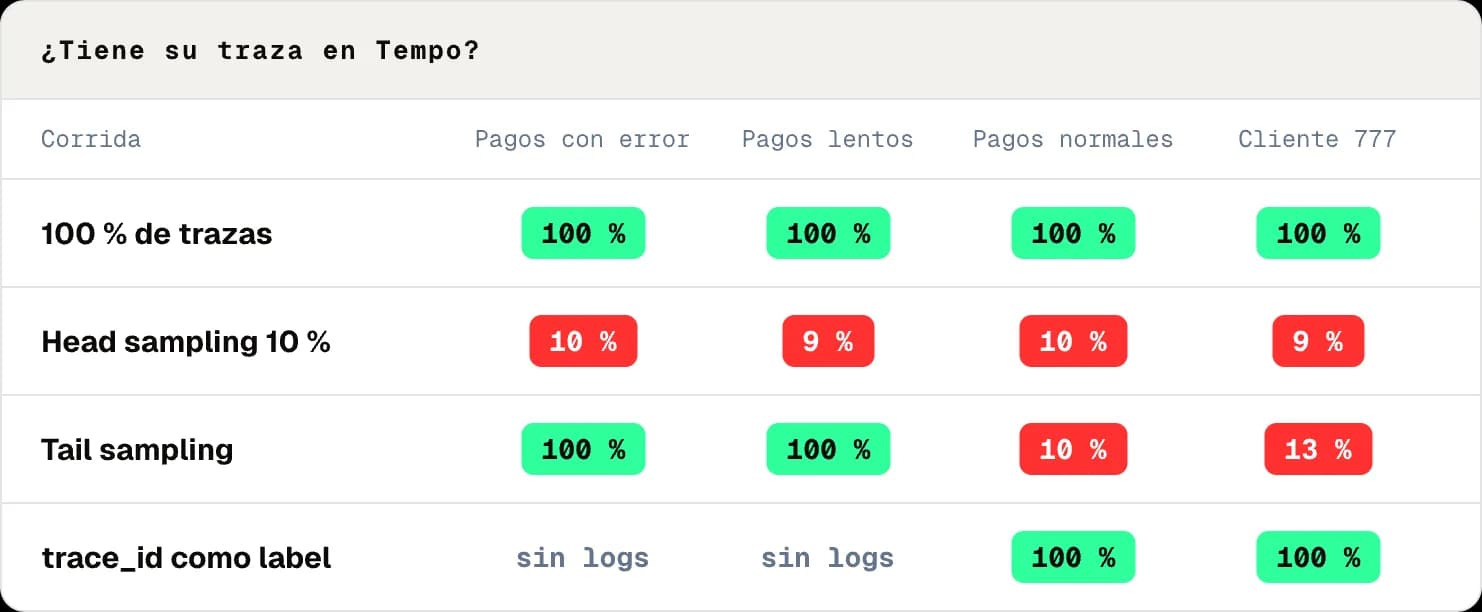
Con el 100 % de las trazas, Tempo encontró las 741 con { span.wallet.id = 777 } en 335 ms. Pero guardar todas las trazas cuesta, y casi nadie lo hace. Canva, por ejemplo, guarda solo el 5 % y aun así procesa 5 mil millones de spans al día. Con muestreo al 10 %, Tempo solo tenía 66 de las 717 trazas de ese cliente (el 9 %), mientras Loki conservaba todas sus líneas.
8. Lo que hace el muestreo
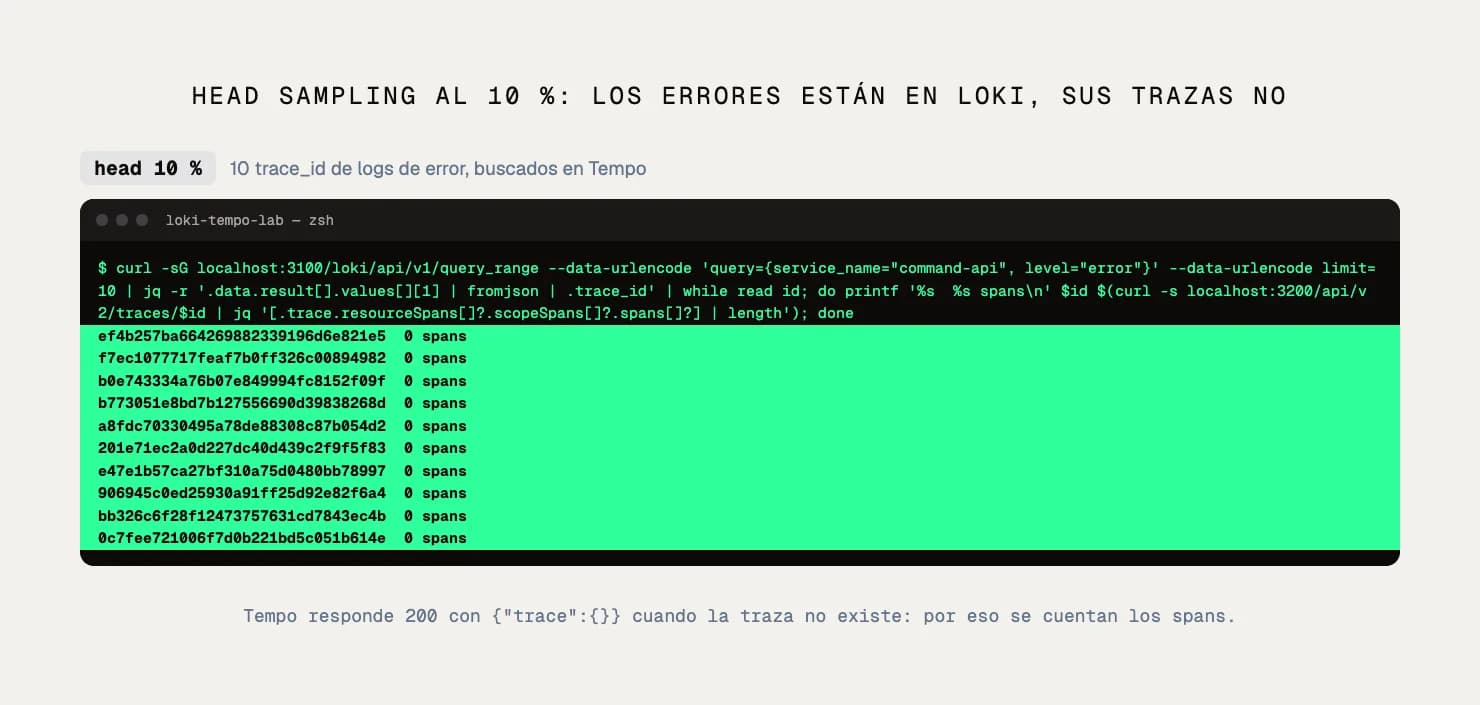
El muestreo más común decide al inicio del request si la traza se guarda (head sampling). Es barato, pero decide antes de saber si el request va a fallar. Con head sampling al 10 %, Tempo guardó el 10 % de las trazas de los pagos con error y el 9 % de los lentos. En los demás casos, el trace_id que aparecía en el log apuntaba a una traza que no existía.
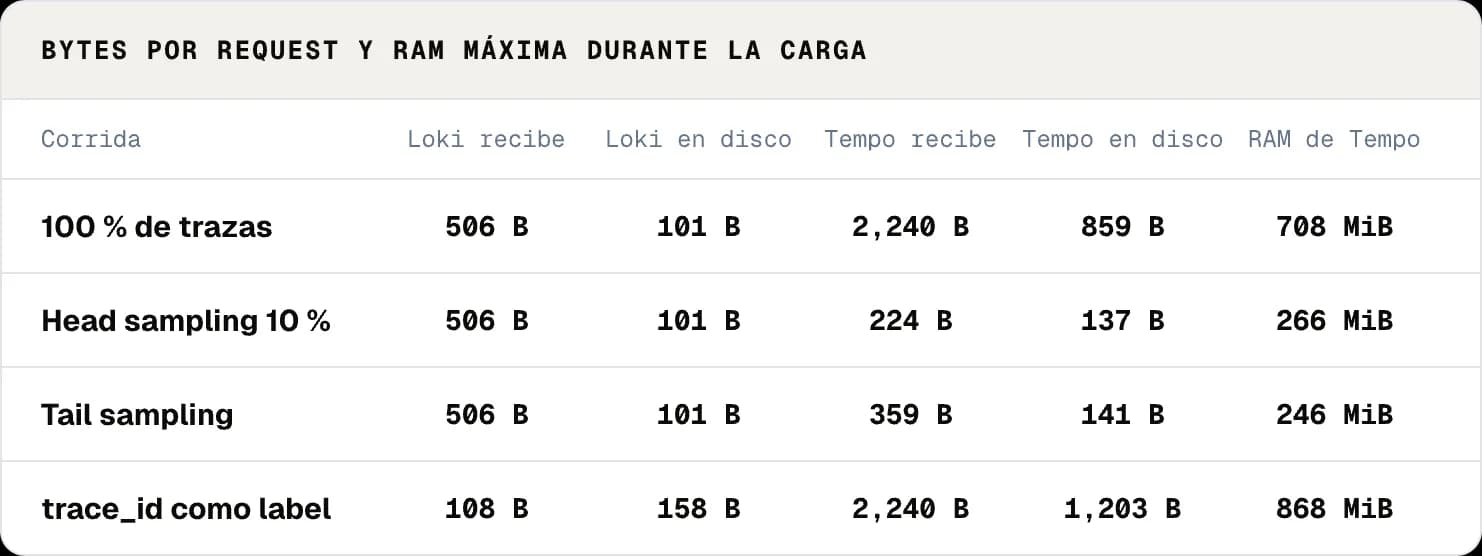
La alternativa es decidir al final (tail sampling): Alloy espera a que termine la traza y guarda todas las que tienen error o pasan de 500 ms, más el 10 % del resto. Con esa regla, Tempo tuvo el 100 % de las trazas con error y de las lentas, y guardó 141 bytes por request, casi lo mismo que head sampling al 10 % (137). A cambio, la RAM de Alloy pasó de 85 a 128 MiB. Además, el recolector tiene que guardar en memoria cada traza mientras decide, y todos los spans de una traza deben llegar a la misma instancia; con varias instancias, hace falta una capa de balanceo antes.

Para comprobarlo hay que contar los spans: cuando una traza no existe, Tempo 3.0 responde 200 con una traza vacía, así que el código HTTP no sirve de prueba. En la corrida de verificación con head sampling, ninguno de los 10 errores que tomamos de Loki tenía su traza en Tempo.
9. Cómo se conectan, y el error que los desconecta
La unión es el trace_id. En Grafana, un campo derivado en Loki convierte el trace_id de cada línea en un enlace a Tempo, y la opción traces to logs de Tempo abre los logs de un span. Las dos direcciones se configuran por separado.
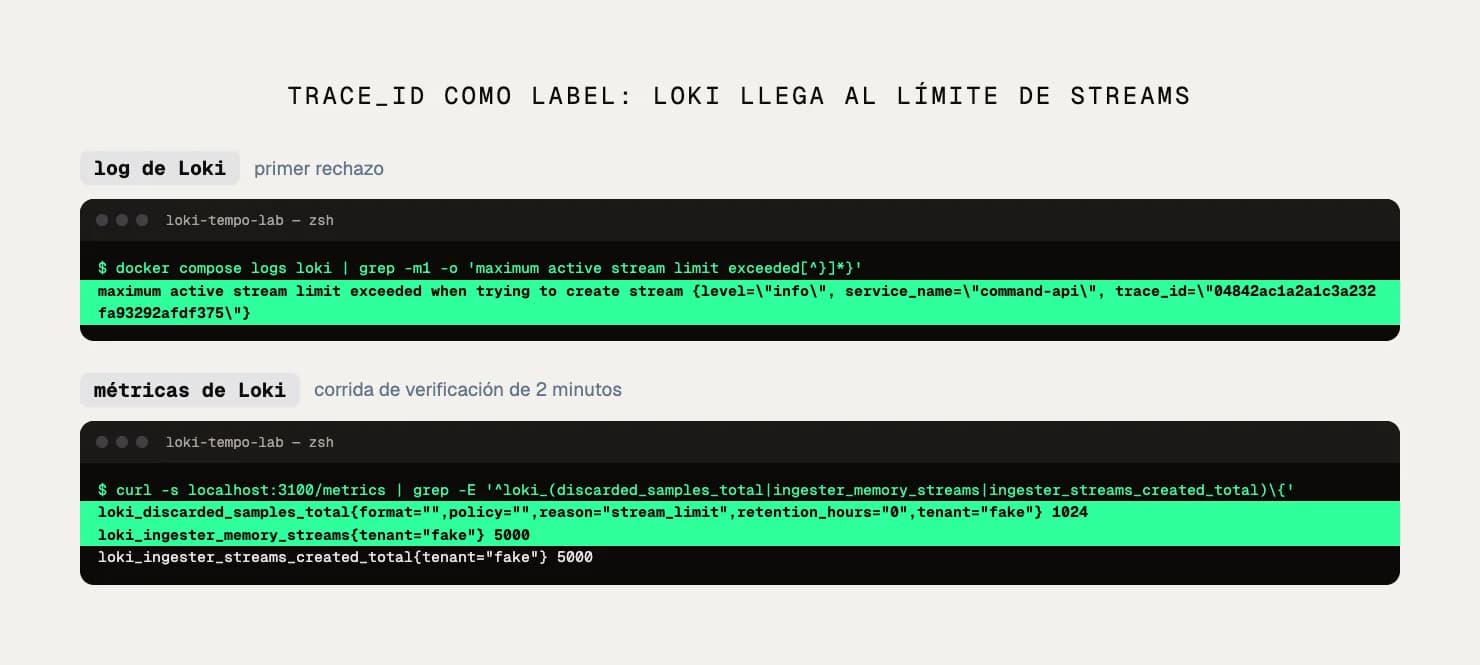
Dónde se guarda el trace_id en Loki importa. Como structured metadata, buscar por un trace_id tardó 171 ms y leyó 85 MB. La tentación es convertirlo en etiqueta para que la búsqueda sea instantánea, y lo probamos: {trace_id="…"} tardó 2 ms. Pero cada trace_id crea un flujo nuevo. A los 44 segundos de empezar la corrida, Loki llegó a su límite de 5,000 flujos activos y empezó a rechazar los logs nuevos. De unas 258,000 líneas, quedaron guardadas unas 18,000 y ningún log de error de la ventana de fallas. La guía de cardinalidad de Loki lo advierte: nombra al trace ID entre los valores que no deben ser etiquetas.

10. Cuánto cuesta cada uno
Por cada request, Loki recibió 506 bytes (1.6 líneas) y guardó 101 bytes en disco. Tempo recibió 2,240 bytes (5.6 spans) y guardó 859 bytes: 8.5 veces más espacio que los logs. Durante la carga, Tempo usó en promedio 9 % de un núcleo y llegó a 708 MiB de RAM; Loki, 0.6 % y 138 MiB. Con head sampling al 10 %, Tempo bajó a 137 bytes por request y 266 MiB; con tail sampling, a 141 bytes y 246 MiB.
Son cifras de un solo nodo con disco local, que Grafana recomienda solo para desarrollo. En producción ambos usan almacenamiento de objetos, pero la proporción entre logs y trazas se mantiene como referencia.
11. Cuándo usar cada uno
Loki responde qué pasó y a quién: errores con su motivo, auditoría y búsquedas por cliente o por pedido. Como guarda todas las líneas, sirve para esas búsquedas, y sale barato mientras las consultas empiecen por etiquetas. Tempo responde dónde se fue el tiempo en un recorrido entre servicios, y es la única evidencia cuando la demora está en un tercero que no te da sus logs. Cuesta más por request, por eso casi siempre se muestrea, y el muestreo decide qué trazas vas a poder ver.
Con los números del laboratorio, recomendamos guardar todos los logs en Loki con el trace_id como structured metadata y mandar a Tempo las trazas con tail sampling, conservando las que tienen error o demora. En Grafana, los dos quedan enlazados por ese trace_id. Si solo puedes empezar con uno y tu problema es "¿qué le pasó a este cliente?", empieza por los logs. Si tu problema es "¿por qué está lento?", necesitas trazas.
El laboratorio completo está en github.com/idtt-pe/loki-tempo-lab. Con Docker, tools/bench.sh repite las cuatro corridas y escribe el resumen en results/summary.md, y tools/evidencia.sh genera las salidas de las capturas de este estudio.
Más notas del equipo
/ QUIERO ALGO SIMILAR
Tu próximo proyectoempieza hoy.
Cuéntanos qué necesitas y te decimos cómo lo resolveríamos.
Hablemos
O escríbenos directo → hola@identity.pe