
CQRS contra CRUD, medido en una billetera
Armamos la misma billetera digital dos veces, una con CRUD y otra con CQRS, y las pusimos bajo carga con el mismo hardware. En un día normal empataron. Cuando los reportes se dispararon, los pagos de CRUD pasaron a tardar casi dos segundos y los de CQRS siguieron en milisegundos.
Cuando se habla de CQRS, casi siempre se habla de rendimiento: separar lecturas y escrituras para que el sistema aguante más. Quisimos comprobarlo con números. Armamos la misma billetera digital dos veces, una con el diseño tradicional (CRUD) y otra con CQRS, les dimos exactamente el mismo hardware y las pusimos bajo carga.
Los resultados no fueron los que esperábamos. En un día normal empataron. Con el mismo hardware, CRUD atendió más lecturas por segundo. Y en el escenario para el que existe el patrón, un pico de reportes, CQRS ganó por una diferencia de tres órdenes de magnitud. En este estudio explicamos CQRS paso a paso, contamos cómo lo medimos y mostramos dónde conviene y dónde no. El laboratorio es público: github.com/idtt-pe/cqrs-lab.
1. El problema que CQRS promete resolver
En una billetera digital hay dos tipos de operaciones. Las escrituras cambian el estado: un pago descuenta saldo y registra el movimiento, una recarga lo suma. Las lecturas solo muestran: el saldo, los últimos movimientos, el gasto del mes por categoría, las ventas del día de un comercio. Las escrituras tienen que ser exactas y rápidas, porque hay una persona esperando en la caja. Las lecturas son muchas más y algunas son caras, porque suman y agrupan miles de filas.
Cuando las dos usan la misma base y las mismas tablas, compiten por la misma CPU. Un tablero que suma las ventas de la última semana de un comercio grande ocupa la base durante varios milisegundos. Si cientos de comercios lo piden a la vez, los pagos empiezan a esperar su turno.

La proporción entre lecturas y escrituras está documentada. Greg Young, quien difundió CQRS, escribió en 2010 que el lado de las consultas suele procesar dos o más órdenes de magnitud más operaciones que el de las escrituras. Facebook midió en su almacén TAO que solo el 0.2% de los requests eran escrituras. Uber contó en 2024 que sus lecturas llegan a ser órdenes de magnitud más que sus escrituras y que, en esos casos, el nodo de MySQL no da abasto y la latencia sube. Nubank reconoció en 2017 que calcular agregaciones sobre su base transaccional, incluso algo tan simple como contar cuántos clientes tenía, no escaló.
2. Qué es CQRS
CQRS significa Command Query Responsibility Segregation: separar la responsabilidad de los comandos y la de las consultas. Un comando pide un cambio (pagar, recargar) y solo devuelve la confirmación. Una consulta devuelve datos y no cambia nada. La idea viene de un principio más antiguo, CQS, que Bertrand Meyer aplicaba a los métodos de un objeto. Greg Young la llevó a la arquitectura y la resumió así: CQRS es crear dos objetos donde antes había uno.
En su forma mínima, CQRS no exige dos bases de datos. Microsoft lo aclara en su guía de arquitectura: cada lado tiene su propio modelo, que no necesariamente vive en otra base. En el laboratorio, con NestJS y @nestjs/cqrs, un pago es un comando con su handler y el estado de cuenta es una consulta con el suyo. El controlador no sabe cómo se resuelve ninguno de los dos.
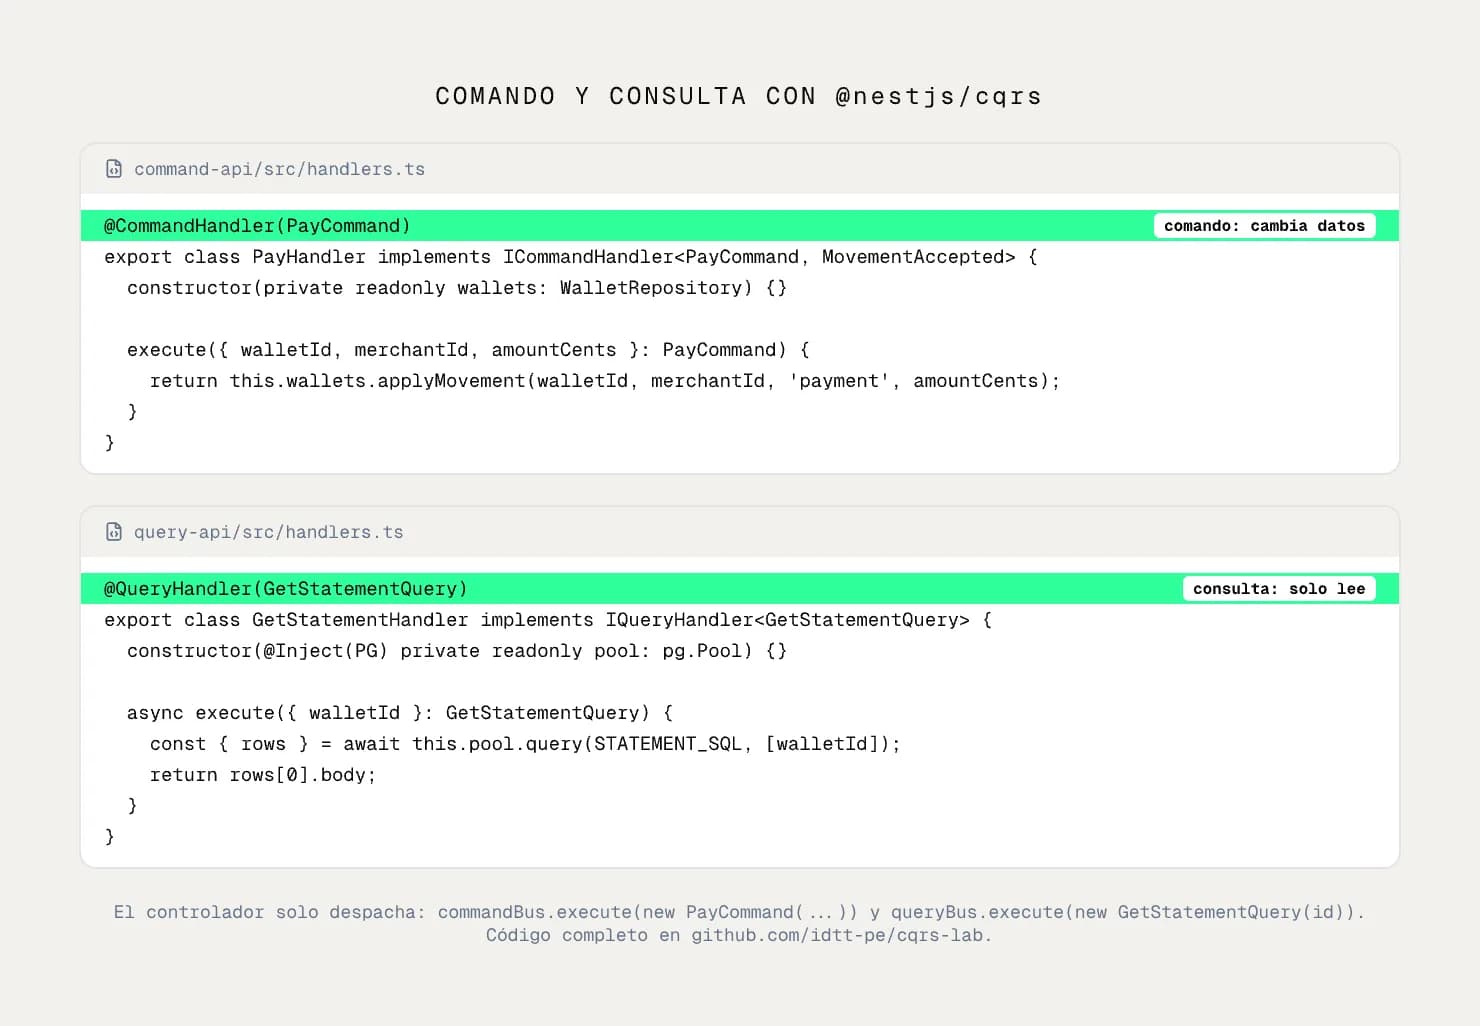
Separar el código ordena el sistema, pero no cambia el rendimiento: las dos partes siguen leyendo y escribiendo en la misma base. La promesa de rendimiento aparece cuando cada lado tiene además su propio almacenamiento. Ese es el CQRS que medimos: los comandos escriben en una base pensada para transacciones y las consultas leen de otra, armada a la medida de cada pantalla. Entre las dos hay que mover los datos, y ahí está casi toda la complejidad del patrón.
3. El laboratorio: la misma billetera, dos veces
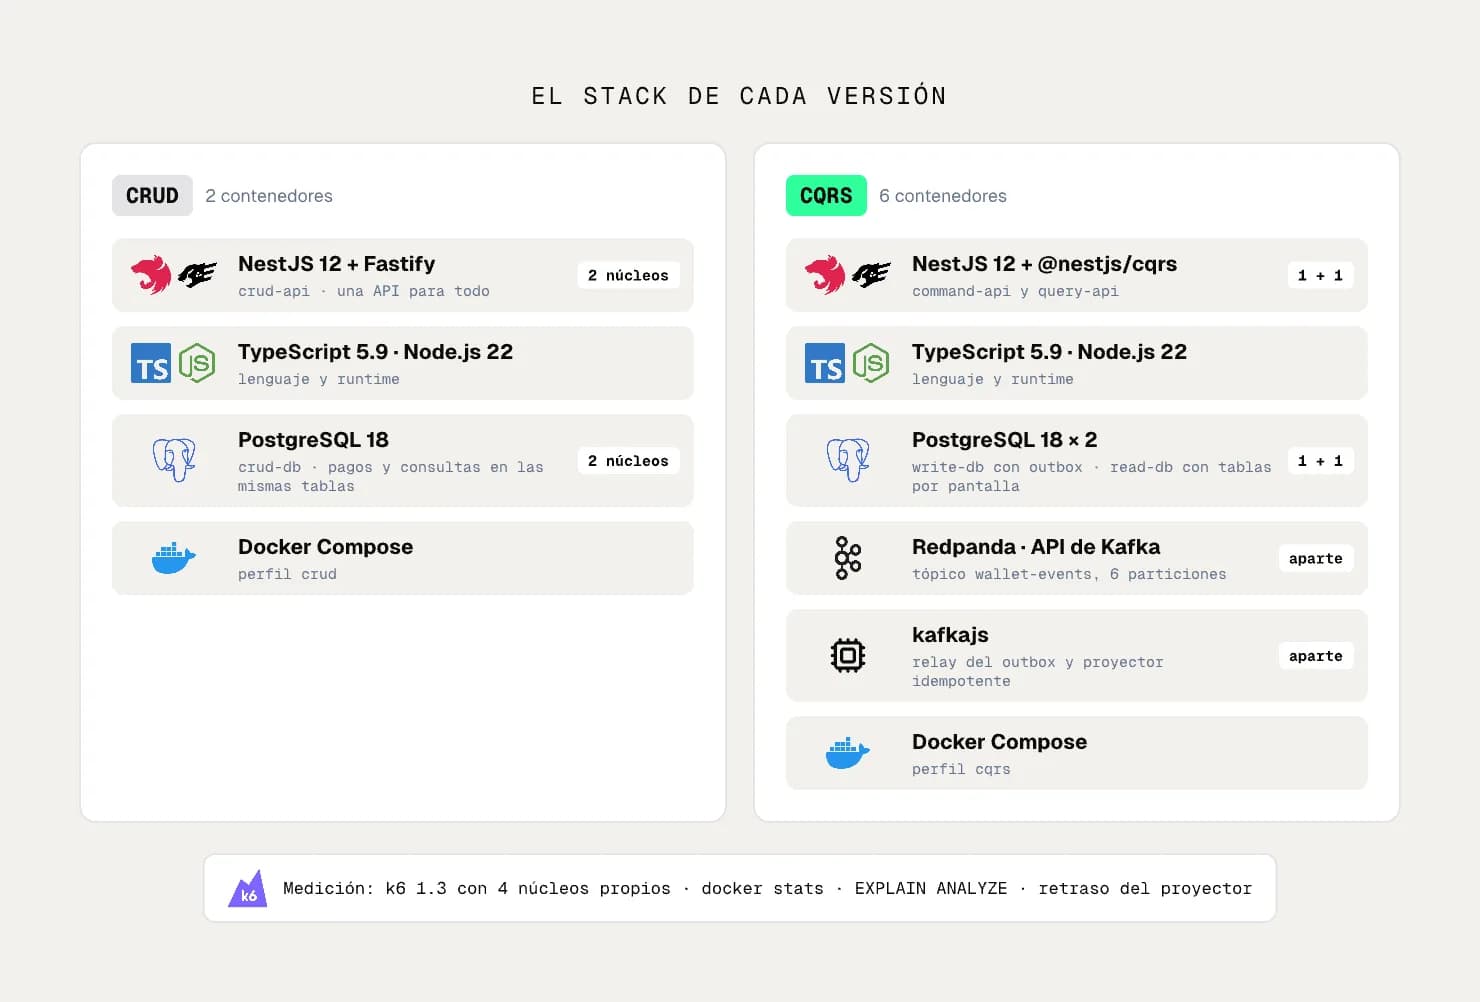
Construimos la billetera con NestJS 12 y Postgres 18. Las dos versiones exponen la misma API: pagar, recargar, ver el estado de cuenta y ver el tablero de un comercio. El estado de cuenta trae el saldo, los últimos 20 movimientos y el gasto del mes por categoría. El tablero trae las ventas del día, las ventas por hora y las de los últimos siete días.
La versión CRUD tiene una API y una base. Sus consultas suman y agrupan en el momento sobre la tabla de transacciones, con índices diseñados para ellas: quisimos comparar contra un CRUD bien hecho, no contra uno armado para perder. La versión CQRS tiene una API de comandos con su base de escritura, una API de consultas con su base de lectura y, entre ellas, un outbox, Kafka (con Redpanda) y un proceso proyector.
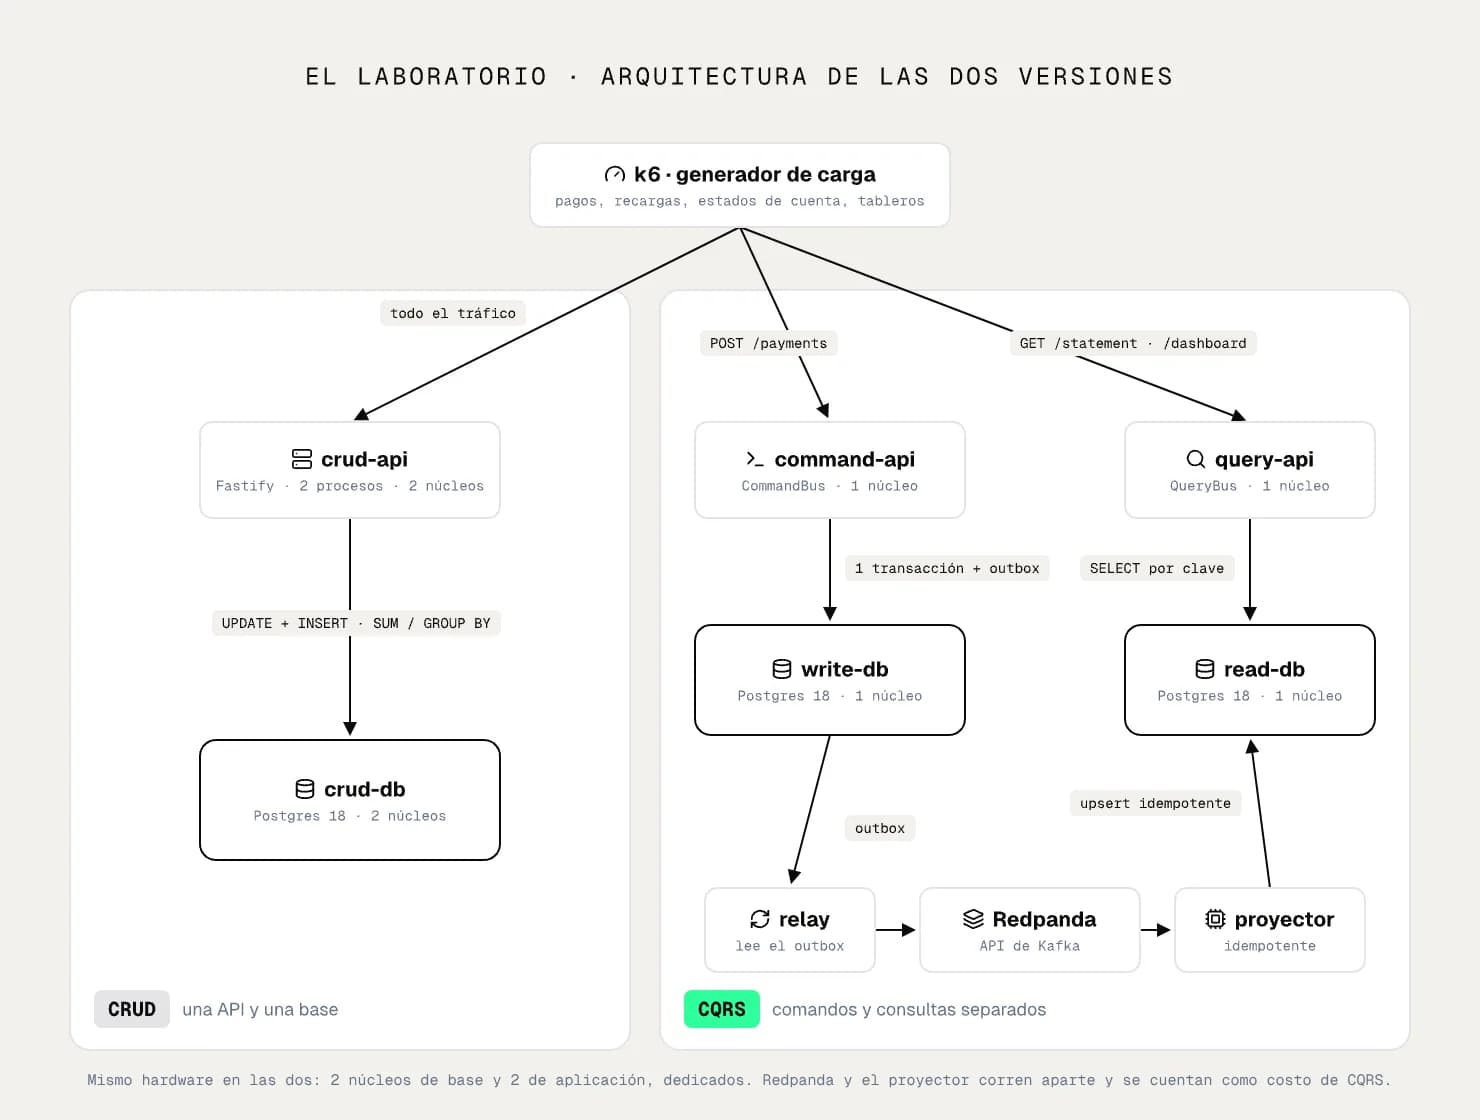
Las dos arrancan con los mismos datos: 200,000 billeteras, 5,000 comercios y 3 millones de transacciones de los últimos 30 días. Como en la vida real, pocos comercios concentran la mayoría de las ventas; el más grande vende unas 5,000 veces al día.
Para que la comparación fuera justa, las dos versiones tienen 2 núcleos de CPU para la base de datos y 2 para la aplicación. En CQRS, un núcleo es de la base de escritura y otro de la de lectura. La memoria alcanza para que cada base tenga sus datos en caché, así que lo que medimos es el uso de CPU. Kafka y el proyector corren aparte y los contamos como costo de CQRS. Las pruebas se hicieron con k6 en una sola máquina; más adelante contamos qué no mide este laboratorio.
4. El lado de escritura: el pago y el outbox en la misma transacción
Cuando entra un pago, la API de comandos descuenta el saldo, registra el movimiento y deja un evento en una tabla llamada outbox. Las tres cosas ocurren en la misma transacción de Postgres: se guardan todas o ninguna.
Parece más simple publicar el evento directo en Kafka después de guardar el pago, pero la base y Kafka son dos sistemas distintos y no comparten transacción. Si el proceso se cae entre las dos operaciones, queda un pago sin evento y la base de lectura nunca se entera. Con el outbox, el evento queda guardado junto con el pago y un proceso aparte, el relay, lo lee de la tabla, lo publica en Kafka y lo borra.
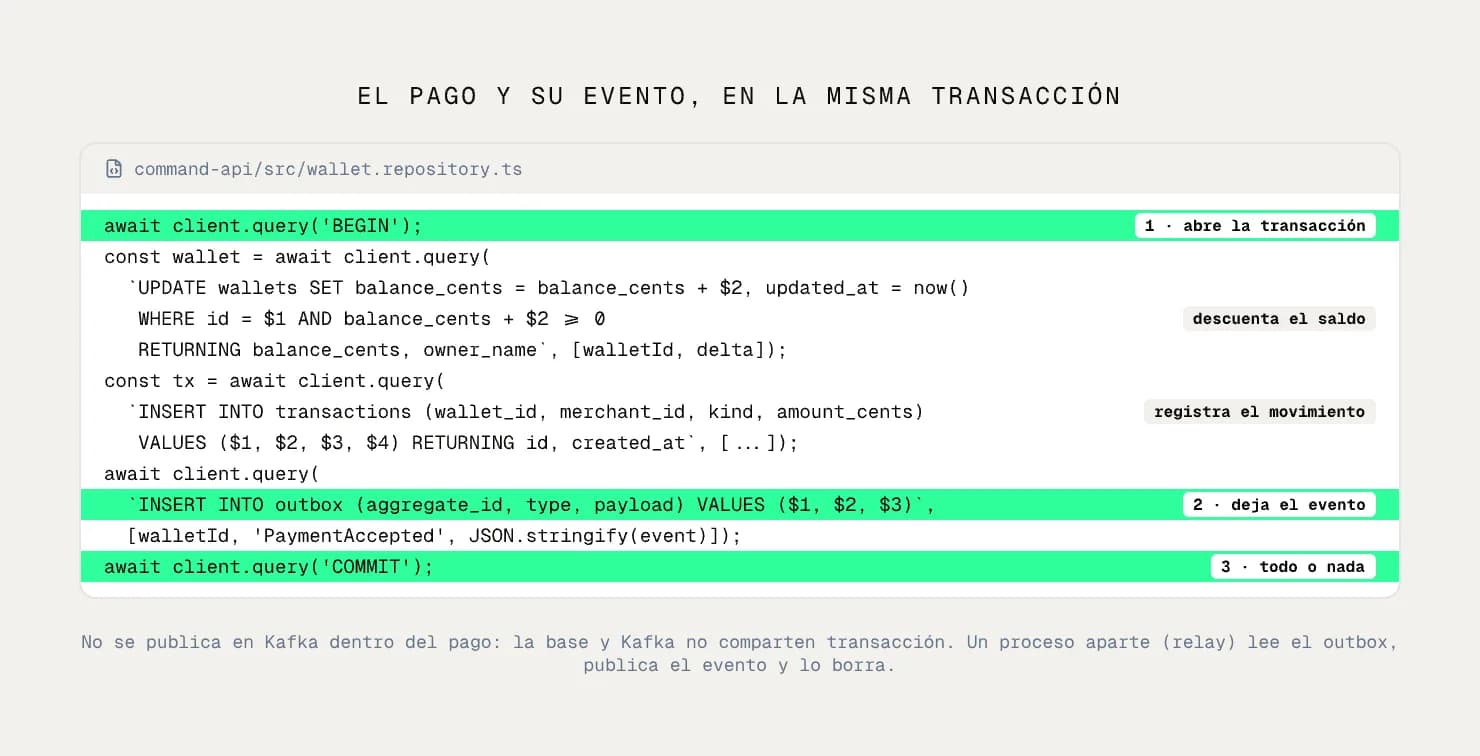
El relay publica cada evento con el identificador de la billetera como clave de Kafka, para que los movimientos de una misma billetera lleguen en orden. Kafka entrega cada evento al menos una vez, así que un evento puede llegar dos veces y el lado de lectura tiene que estar preparado para eso.

Gunnar Morling, de Debezium, explicó en 2019 por qué no se puede tener una transacción que abarque la base y Kafka a la vez, y lo resumió en 2024 con una frase: "Friends don't let friends do dual writes". AWS recomienda hacer idempotente al consumidor registrando los mensajes ya procesados, y Microsoft pide, para CQRS, guardar el cambio y el evento de forma atómica con un outbox y que el consumidor del modelo de lectura tolere duplicados.
5. El lado de lectura: una tabla por pantalla
El proyector consume los eventos de Kafka y actualiza la base de lectura. Esa base no tiene la tabla de transacciones: tiene una tabla por cada cosa que muestra la app. El saldo de cada billetera, sus movimientos con el nombre del comercio ya escrito, el gasto del mes por categoría ya sumado y las ventas de cada comercio por hora, también ya sumadas. Cuando entra un pago, el proyector suma una venta a la hora que corresponde y un monto a la categoría del mes. Cuando alguien pide su tablero, la base solo tiene que leer.
Para tolerar duplicados, el proyector inserta cada movimiento con su identificador y, si ya existía, no suma nada. Lo probamos borrando el avance del consumidor y releyendo el tópico completo desde el inicio: el proyector aplicó cero eventos y los totales de la base de lectura no cambiaron.
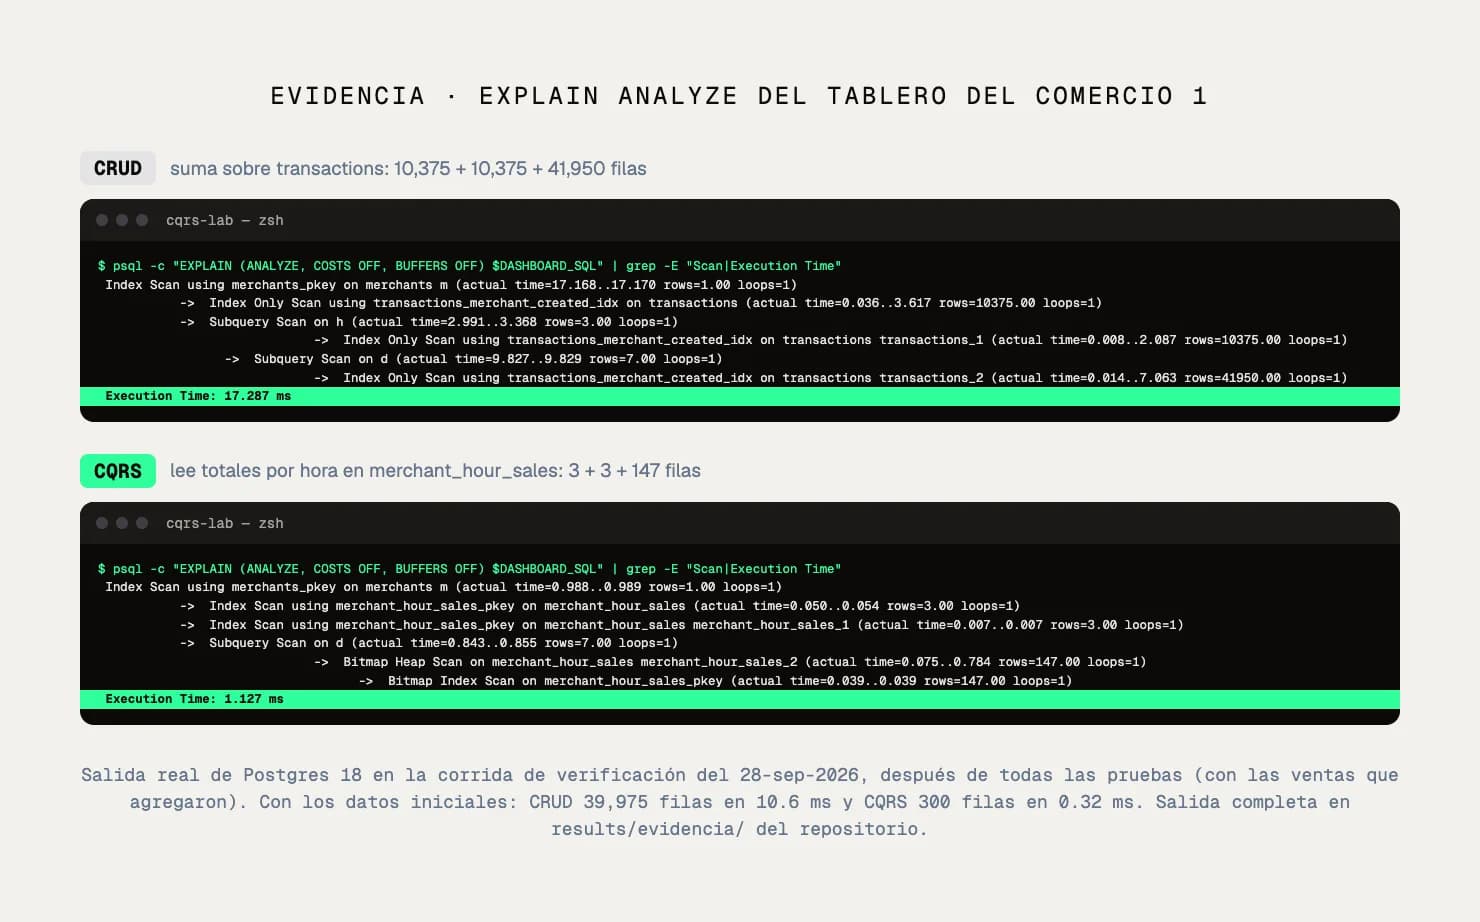
La diferencia se ve en cuánto trabaja cada consulta. Le pedimos a Postgres que ejecutara el tablero del comercio más grande en las dos versiones y contara las filas que leía. Con los datos iniciales, CRUD leyó 39,975 filas en 10.6 ms y CQRS leyó 300 filas en 0.32 ms. Después de todas las pruebas, con más ventas acumuladas, CRUD ya leía 60,589 filas en 16.2 ms y CQRS seguía en 304 filas y 0.37 ms. En CRUD, el costo del tablero crece con las ventas del comercio; en CQRS depende de cuántas horas muestra.

Airbnb hizo algo parecido con sus datos de pagos. En 2022 contó que movió el trabajo caro del momento de la consulta al momento de la ingesta: desnormalizó más de 10 tablas en un par de índices y logró hasta 150 veces menos latencia, con un retraso de replicación de menos de 10 segundos. En 2023 presentó Riverbed, que procesa 2,400 millones de eventos al día y mantiene más de 50 vistas materializadas. Wix llama a este patrón "Consume and Project" y lo aplicó a un servicio que recibía más de un millón de requests por minuto: separó un servicio solo de lectura, alimentado por una proyección optimizada para sus consultas. Modern Treasury guarda el saldo de cada cuenta ya calculado, para que leerlo cueste lo mismo sin importar cuántos movimientos tenga.
6. Primera sorpresa: en un día normal, empate
La primera prueba fue un día cualquiera. Durante dos minutos, las dos versiones recibieron el mismo tráfico: 100 pagos y 10 recargas por segundo, 400 estados de cuenta y 40 tableros por segundo. Repetimos la prueba tres veces y tomamos la mediana.
Para leer las cifras usamos percentiles. Si se ordenan todas las respuestas de la más rápida a la más lenta, el p50 es la del medio, la experiencia típica, y el p99 es la número 99 de cada 100, los casos lentos. Con 100 pagos por segundo, un p99 malo significa que un pago cada segundo, 86,400 al día, se demora.
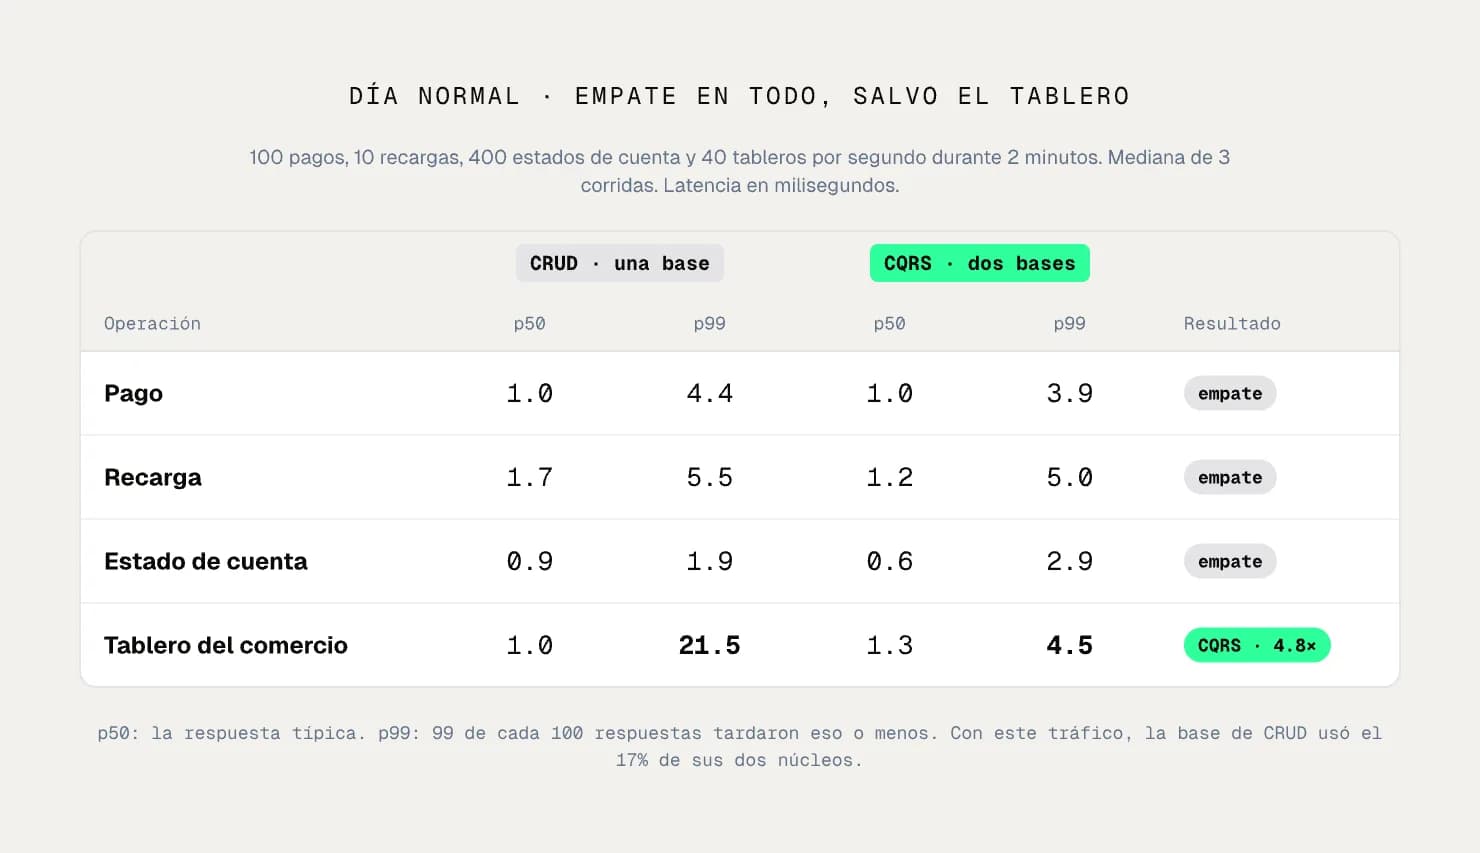
El pago tuvo un p99 de 4.4 ms en CRUD y de 3.9 ms en CQRS. El estado de cuenta, 1.9 ms y 2.9 ms. La única diferencia marcada fue el tablero del comercio: 21.5 ms de p99 en CRUD, que suma miles de ventas en cada consulta, contra 4.5 ms en CQRS, que lee totales ya calculados. Con este tráfico, la base de CRUD usó el 17% de sus dos núcleos. Un CRUD con buenos índices alcanza de sobra para esta carga, y CQRS le agregaría piezas sin una mejora que el usuario note.
7. Segunda sorpresa: con el mismo hardware, CRUD atiende más lecturas
La segunda prueba mandó solo lecturas, nueve estados de cuenta por cada tablero, y fue subiendo de 1,000 a 6,000 por segundo. CRUD sostuvo unas 3,000 lecturas por segundo con un p95 de 14 ms. CQRS sostuvo unas 2,000 con un p95 de 29 ms y se saturó cerca de 3,100.
La razón está en el reparto del hardware. Cuando nadie escribe, CRUD pone sus dos núcleos de base a leer. CQRS lee con uno solo, porque el otro está reservado para la escritura y queda ocioso.
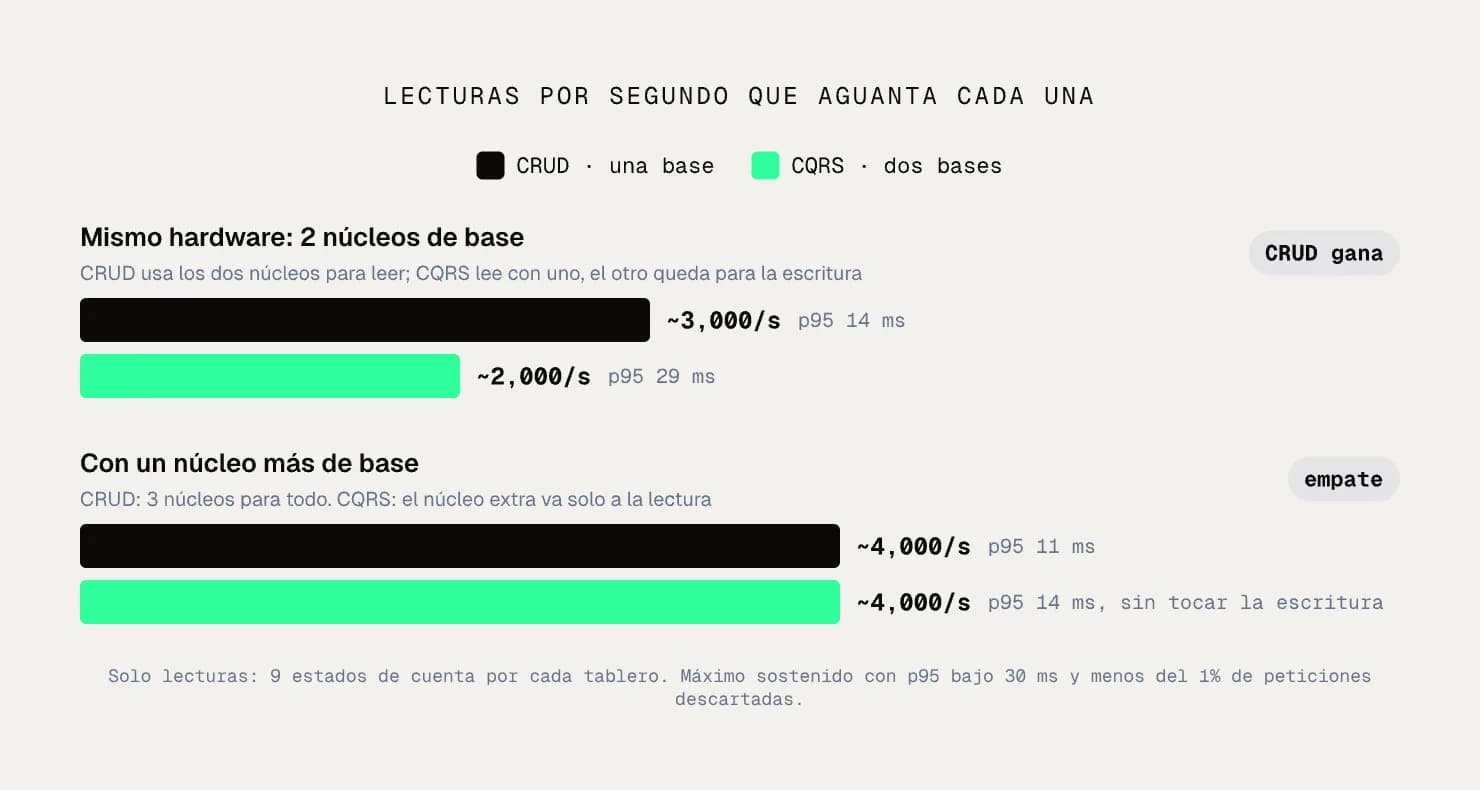
Lo que CQRS sí permite es crecer por partes. Le dimos un núcleo más a cada versión: CRUD pasó a tres núcleos para todo y CQRS sumó el núcleo solo a la lectura. CQRS subió a unas 4,000 lecturas por segundo con un p95 de 14 ms sin tocar el lado de escritura, y CRUD llegó también a 4,000, con un p95 de 11 ms. En capacidad de lecturas simples, un CRUD bien indexado sigue siendo competitivo.
8. Donde CQRS gana: el pico de reportes
La tercera prueba es el escenario que justifica el patrón. Dejamos los pagos fijos en 100 por segundo y subimos los tableros por escalones, de 0 a 3,200 por segundo, un minuto cada uno. Es lo que pasa a fin de mes, cuando todos los comercios revisan sus ventas al mismo tiempo. La pregunta es qué le pasa a un pago cuando los reportes suben.

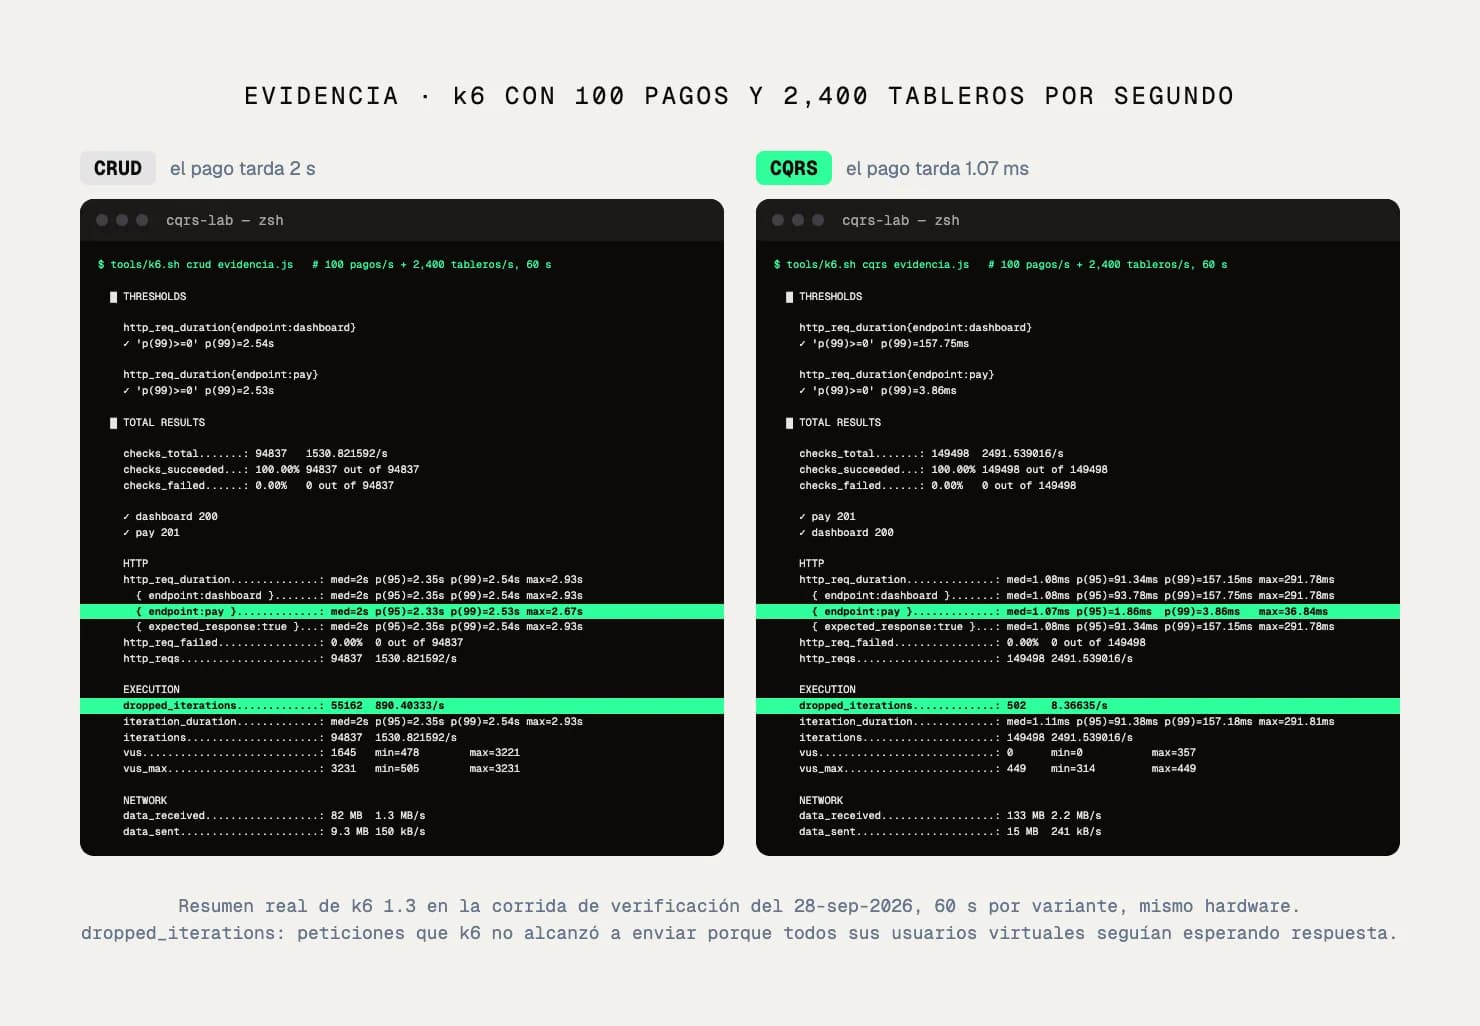
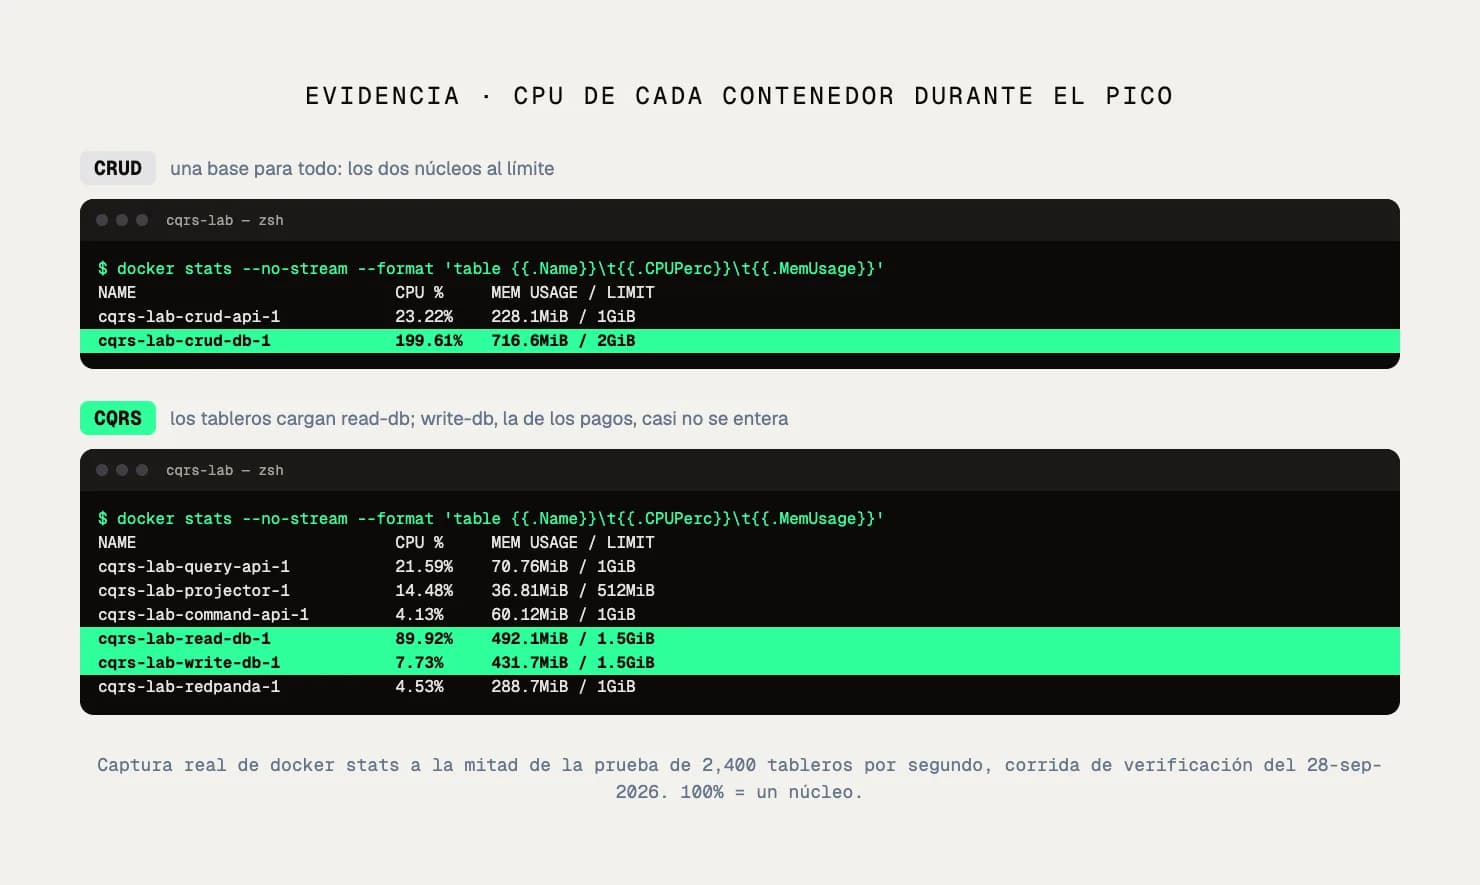
En CRUD, el pago se fue degradando a medida que subían los tableros: 4.6 ms de p99 sin tableros, 6.3 ms con 800 por segundo y 32.2 ms con 1,600. Con 2,400 tableros por segundo la base llegó al límite de sus dos núcleos y el pago típico pasó a tardar 1.9 segundos. El generador de carga ni siquiera pudo enviar 158 de los 6,000 pagos de ese minuto, porque todos sus clientes seguían esperando respuesta.
En CQRS, el p99 del pago quedó por debajo de 5 ms en todos los escalones, incluido el de 3,200 tableros por segundo, salvo un salto aislado de 43.5 ms en el de 200. La base de escritura no pasó del 11% de CPU en ninguno. Con 3,200 tableros por segundo la que llegó a su límite fue la base de lectura, y los tableros tardaron más de un segundo, pero los pagos siguieron igual, porque la sobrecarga de las lecturas quedó en su propia base. Con 2,400 tableros por segundo, el pago típico tardó 0.9 ms en CQRS y 1,879 ms en CRUD.
Las capturas de abajo son la salida real de una corrida de verificación con 2,400 tableros por segundo. En CRUD, el pago tardó 2 segundos en la mediana y la base usó el 199.61% de CPU, es decir, sus dos núcleos completos. En CQRS tardó 1.07 ms, con la base de escritura al 7.73%.
9. El precio
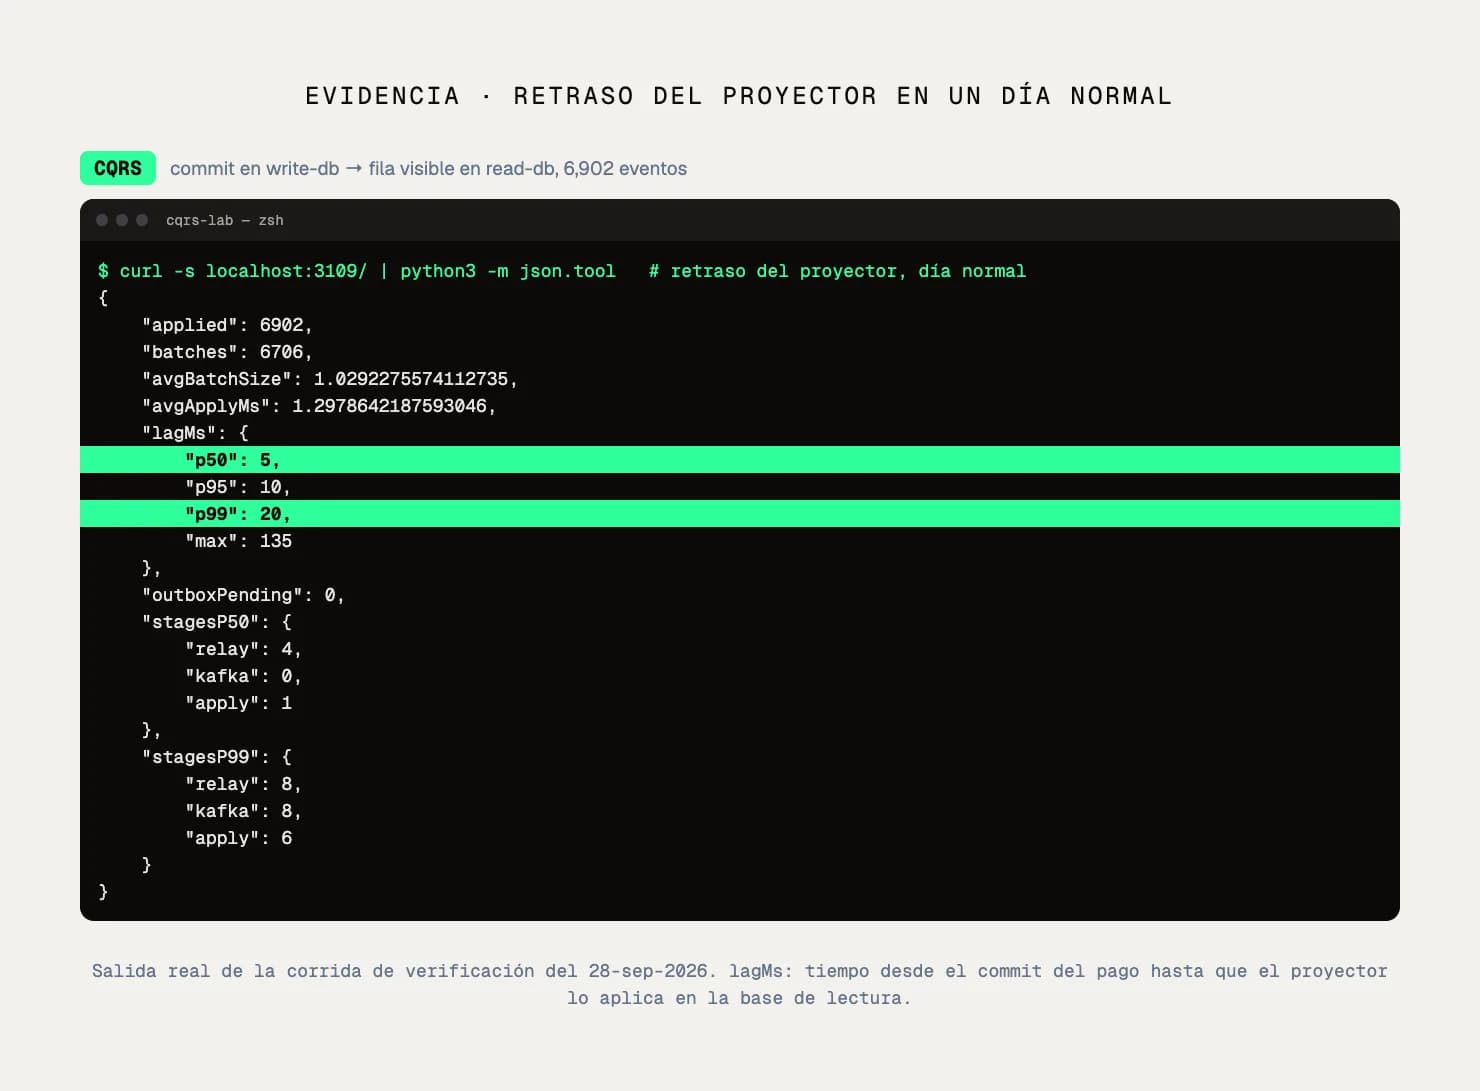
CQRS tiene costos, y el primero es la consistencia eventual. En la prueba del día normal, 5 pagos por segundo consultaban su estado de cuenta inmediatamente después de pagar. En CQRS, el 99.8% de esas lecturas todavía no mostraba el pago. El pago aparecía a los 8 ms en la mediana, a los 15 ms en el p95 y a los 20 ms en el p99. En CRUD aparecía siempre. Unos milisegundos no importan en un tablero, pero sí en una pantalla que dice "pago exitoso" y muestra el saldo anterior. Esa pantalla tiene que usar la respuesta del comando, que ya trae el saldo nuevo, en vez de volver a preguntar a la base de lectura.

También hay más piezas que operar. CRUD son 2 contenedores; CQRS, 6: dos APIs, dos bases, Kafka y el proyector, cada uno con su monitoreo, sus alertas y sus fallas posibles. Nos pasó al armarlo: el primer cliente de Kafka que probamos entregaba los eventos con 13 a 30 segundos de retraso y tuvimos que cambiarlo.
Y ocupa más espacio. Con los datos iniciales, la base de CRUD pesa 617 MB. En CQRS, la base de escritura pesa lo mismo y la de lectura agrega 757 MB, porque guarda los mismos datos de otra forma: 2.2 veces el espacio.
Netflix lo vivió en su sitio Tudum. Usaba CQRS con Kafka y una base de lectura, y contó en 2025 que la mayor desventaja era la demora entre editar una página y ver el cambio publicado. Terminó quitando Kafka de ese camino, y su conclusión fue que CQRS es un paradigma poderoso para escalar si se puede tolerar algo de consistencia eventual. Martin Fowler advierte que en la mayoría de los sistemas CQRS agrega una complejidad riesgosa, y Udi Dahan fue más lejos: según él, la mayoría de quienes usan CQRS no deberían haberlo hecho.
10. Antes de CQRS: lo que conviene probar primero
Si el problema es que las lecturas cargan la base, hay soluciones más simples. Un índice bien pensado evita leer la tabla completa. Una réplica de lectura saca las consultas del servidor principal sin cambiar el código de negocio. Una base de reportes separada, que se llena cada cierto tiempo, aísla los informes pesados.
Cada una tiene su límite. Un índice no evita sumar miles de filas en cada tablero. Una réplica tiene el mismo esquema que la base principal, así que las consultas hacen el mismo trabajo en otro servidor, y llega con retraso. Una base de reportes que se actualiza de noche no sirve para ver las ventas de hace diez minutos.
incident.io publicó en julio de 2026 cómo movió más del 60% de sus lecturas a una réplica y bajó a la mitad el uso de CPU de su base principal. También contó el costo: entre 0.1% y 0.5% de sus mensajes se procesaban antes de que la réplica tuviera el dato, y tuvieron que verificar la posición de la réplica antes de leer. Shopify advierte que los datos de una réplica pueden tener segundos o incluso minutos de antigüedad. Martin Fowler describía ya en 2004 la base de reportes como una forma de que las consultas no sumen carga a la base operativa.
11. Cuándo conviene y cuándo no
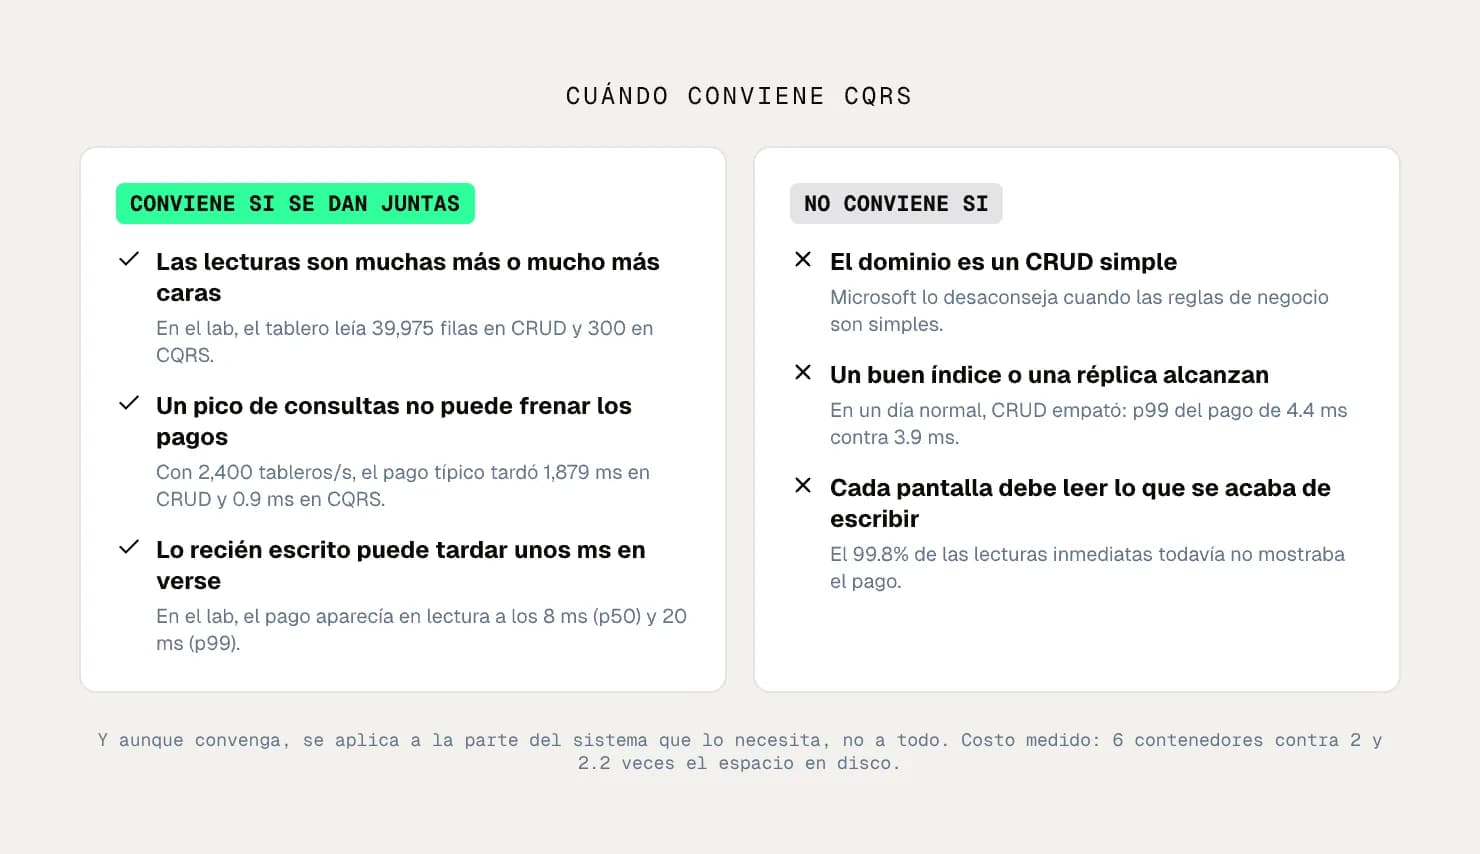
Con lo que medimos, CQRS conviene cuando se dan juntas tres condiciones: las lecturas son muchas más que las escrituras o mucho más caras, un pico de consultas no puede frenar las operaciones que mueven dinero, y el negocio tolera que lo recién escrito tarde unos milisegundos en verse. Una billetera a fin de mes, un sistema de recaudo con tableros en vivo o un marketplace con reportes para miles de vendedores entran en ese grupo.
No conviene cuando el dominio es un CRUD simple, cuando la carga de lectura cabe en una base con buenos índices o en una réplica, o cuando cada pantalla necesita leer lo que se acaba de escribir. Y aunque convenga, se aplica a la parte del sistema que lo necesita. En el laboratorio lo usamos para dos pantallas; el resto de una billetera real podría seguir siendo CRUD.
Microsoft lo recomienda cuando la cantidad de lecturas supera a la de escrituras y lo desaconseja cuando el dominio y las reglas de negocio son simples. AWS pide que las lecturas y escrituras tengan requisitos distintos de escala, latencia y consistencia, y que la consistencia eventual sea aceptable para las consultas. Martin Fowler sugiere aplicarlo solo en partes específicas del sistema.
Este laboratorio tiene límites. Corre en una sola máquina, con Postgres en los dos lados. En producción, el modelo de lectura suele vivir en otro motor, como Elasticsearch o Redis, y se replica en varias instancias; eso no lo medimos. Los tableros cubren siete días de un comercio; reportes más pesados cargarían antes la base de CRUD, pero eso tampoco lo medimos. Y hay beneficios de CQRS que no se miden con carga, como que equipos distintos evolucionen cada lado por separado o que un modelo de lectura junte datos de varios servicios.
El laboratorio completo está en github.com/idtt-pe/cqrs-lab. Con Docker y alrededor de una hora puedes correr las mismas pruebas en tu máquina y comparar tus números con los nuestros.
Fuentes y créditos
Greg Young: "CQRS Documents" (2010). Martin Fowler: "CQRS" (14 jul 2011) y "ReportingDatabase" (2004). Udi Dahan: "When to avoid CQRS" (22 abr 2011).
Microsoft: "CQRS pattern", Azure Architecture Center. AWS: "CQRS pattern" y "Transactional outbox pattern", AWS Prescriptive Guidance. Debezium: "Reliable Microservices Data Exchange With the Outbox Pattern" (Morling, 19 feb 2019). Decodable: "Revisiting the Outbox Pattern" (Morling, 31 oct 2024).
Airbnb Tech Blog: "Unified Payments Data Read at Airbnb" (9 jun 2022) y "Riverbed: Optimizing Data Access at Airbnb's Scale" (25 jul 2023). Netflix TechBlog: "Netflix Tudum Architecture: from CQRS with Kafka to CQRS with RAW Hollow" (10 jul 2025). Wix Engineering: "6 Event-Driven Architecture Patterns, Part 1" (Silnitsky, 3 may 2020). Modern Treasury: "Behind the Scenes: How We Built Ledgers for High Throughput" (McNierney, 25 ene 2024).
Facebook: "TAO: Facebook's Distributed Data Store for the Social Graph" (USENIX ATC 2013). Uber Engineering: "How Uber Serves Over 40 Million Reads Per Second Using an Integrated Cache" (15 feb 2024). Nubank: charla de Edward Wible en QCon San Francisco (dic 2017). incident.io: "Don't add a read replica until you've read this" (21 jul 2026). Shopify Engineering: "Read Consistency with Database Replicas" (Saunders, 22 feb 2021).
Los diagramas, las animaciones y las mediciones son de idtt. El código, los escenarios de carga y la salida de cada corrida están en github.com/idtt-pe/cqrs-lab.
Más notas del equipo
/ QUIERO ALGO SIMILAR
Tu próximo proyectoempieza hoy.
Cuéntanos qué necesitas y te decimos cómo lo resolveríamos.
Hablemos
O escríbenos directo → hola@identity.pe